Mô hình học mối liên hệ giữa chữ và hình từ rất nhiều cặp ảnh kèm chú thích. Sau đó, nó dựng ảnh mới từng bước từ nhiễu ngẫu nhiên. Stable Diffusion, một mô hình mở chạy được trên máy tính riêng, dựa trên kiểu mô hình khuếch tán. Nó học từ một phần bộ dữ liệu LAION-5B gồm 5,85 tỷ cặp ảnh và chữ.
Ảnh AI mạnh về ánh sáng và phong cách, nhưng vẫn hay sai ở chữ trong ảnh và hình người. Nhiều mô hình mặc định tạo ảnh quanh 1 megapixel, đủ cho màn hình. Để đánh dấu nguồn gốc, các hãng dùng thủy vân số và chuẩn C2PA. Người đăng ảnh thì cần gắn nhãn, kiểm tra trước khi đăng và tôn trọng quy định minh bạch của EU.
AI tạo hình ảnh là gì?
AI tạo hình ảnh (tiếng Anh: AI image generation hay text-to-image) là nhóm công cụ tạo ra ảnh chưa từng tồn tại. Mô hình tính ra từng điểm ảnh theo lời mô tả, không đi tìm rồi ghép ảnh có sẵn. Công nghệ này còn được gọi là AI tạo ảnh hay AI Art. Người dùng đưa vào một câu mô tả, gọi là câu lệnh (prompt), hoặc một ảnh mẫu, rồi nhận lại một hay nhiều ảnh mới.
Công nghệ này đi ra từ phòng nghiên cứu trước khi đến tay người dùng. Tháng 2/2021, bài báo CLIP của Alec Radford và cộng sự dạy máy ghép chữ với hình. Tháng 12/2021, bài báo về khuếch tán tiềm ẩn của Robin Rombach và cộng sự giúp tạo ảnh đỡ tốn sức tính toán. Tháng 4/2022, nhóm Aditya Ramesh công bố một mô hình hai tầng tạo ảnh từ chú thích chữ.
Công cụ cho người dùng phổ thông ra đời sau đó. Stability AI phát hành công khai Stable Diffusion với giấy phép CreativeML OpenRAIL-M, cho dùng cả vào việc thương mại lẫn phi thương mại. Adobe đưa Firefly vào dùng thương mại tháng 9/2023, sau sáu tháng thử nghiệm với hơn 2 tỷ lượt tạo. Apple phát hành Image Playground cùng iOS 18.2 vào tháng 12/2024.
AI tạo ảnh thuộc nhóm AI tạo sinh (generative AI), tức các hệ thống làm ra nội dung mới. Cùng nhóm này còn có chatbot và công cụ tạo video.
AI tạo hình ảnh khác chỉnh sửa ảnh truyền thống ở điểm nào?
Phần mềm chỉnh ảnh truyền thống sửa những điểm ảnh đã có, theo từng thao tác của người dùng. AI thì sinh ra điểm ảnh mới theo lời mô tả. Với phần mềm chỉnh ảnh, người dùng quyết định từng nét cắt, từng mảng màu. Với AI, mô hình quyết định phần lớn chi tiết, người dùng chỉ định hướng bằng chữ.
Ranh giới giữa hai cách đang mờ dần. Tháng 5/2023, Adobe ra mắt Generative Fill trong Photoshop, ở dạng bản thử nghiệm (beta). Bản này chưa được dùng vào việc thương mại và chỉ nhận câu lệnh tiếng Anh. Từ tháng 9/2023, Generative Fill và Generative Expand có trong bản Photoshop chính thức.
Khác biệt này quan trọng khi gắn nhãn. Bộ mã Digital Source Type của IPTC ghi lại cách một bức ảnh được làm ra. Bộ mã này tách riêng ảnh "tạo bằng AI tạo sinh" với ảnh "chỉnh sửa bằng AI tạo sinh". Điều 50 khoản 2 Đạo luật AI châu Âu cũng miễn đánh dấu cho hệ thống chỉ hỗ trợ chỉnh sửa thông thường, hoặc không làm thay đổi đáng kể dữ liệu đầu vào.
Khác biệt rõ nhất nằm ở người quyết định chi tiết: người dùng hay mô hình.
| Tiêu chí | Chỉnh sửa ảnh truyền thống | AI tạo hình ảnh |
|---|---|---|
| Đầu vào | Một ảnh có sẵn | Câu mô tả bằng chữ, một ảnh mẫu hoặc cả hai |
| Cách tạo điểm ảnh | Thay đổi điểm ảnh đang có | Sinh điểm ảnh mới, bắt đầu từ nhiễu ngẫu nhiên |
| Mức kiểm soát chi tiết | Người dùng quyết định từng thao tác | Mô hình quyết định phần lớn chi tiết |
| Khả năng tái tạo kết quả | Lặp lại cùng thao tác thì ra cùng kết quả | Mỗi lần chạy thường cho một ảnh khác |
4 cách AI tạo ảnh: từ chữ, từ ảnh có sẵn, vẽ bù và mở rộng khung hình
AI tạo ảnh theo bốn cách: từ chữ (text-to-image), từ ảnh có sẵn (image-to-image), vẽ bù (inpainting) và mở rộng khung hình (outpainting). Theo Amazon Web Services (AWS), Stable Diffusion làm được ba cách đầu.
- Tạo từ chữ: người dùng gõ câu mô tả, mô hình trả về ảnh mới, ví dụ ảnh nền cho một slide thuyết trình. Đây là cách dễ bắt đầu nhất với người mới, vì chỉ cần gõ chữ.
- Tạo từ ảnh có sẵn: người dùng đưa vào một ảnh kèm câu lệnh để nhận ảnh mới, ví dụ đổi ảnh chân dung sang kiểu tranh minh họa. Image Playground của Apple tạo được ảnh giống người thân từ ảnh trong thư viện.
- Vẽ bù: người dùng tô che vùng cần sửa để mô hình vẽ lại vùng đó, ví dụ xóa người lạ khỏi ảnh du lịch. API hình ảnh của OpenAI, tức cổng để phần mềm khác gọi tới mô hình, cũng có chức năng chỉnh sửa ảnh. Kết quả mặc định là tệp PNG.
- Mở rộng khung hình: mô hình vẽ thêm phần nằm ngoài khung gốc, ví dụ biến ảnh dọc thành ảnh ngang. Trong bản Photoshop chính thức, tính năng này có tên Generative Expand từ tháng 9/2023.
Tạo từ chữ là cách duy nhất không cần ảnh đầu vào.
| Cách tạo | Đầu vào | Kết quả | Ví dụ |
|---|---|---|---|
| Từ chữ | Câu mô tả | Ảnh mới hoàn toàn | Ảnh nền slide |
| Từ ảnh có sẵn | Ảnh mẫu và câu lệnh | Ảnh mới dựa trên ảnh mẫu | Đổi phong cách ảnh chân dung |
| Vẽ bù | Ảnh có vùng bị tô che | Vùng che được vẽ lại | Xóa người lạ khỏi ảnh du lịch |
| Mở rộng khung | Ảnh gốc và khung lớn hơn | Phần mới quanh ảnh gốc | Ảnh dọc thành ảnh ngang |
Vẽ bù và tạo từ ảnh có sẵn dễ gây hiểu lầm nhất khi ảnh có người thật. Lý do là kết quả vẫn mang dáng một bức ảnh chụp đã có.
AI tạo hình ảnh hoạt động như thế nào?
Mô hình làm việc qua hai bước. Trước hết, nó hiểu câu mô tả nhờ những gì đã học từ dữ liệu huấn luyện. Sau đó, nó dựng ảnh từ một khối nhiễu ngẫu nhiên cho tới khi ảnh khớp với câu mô tả. Theo AWS, ở Stable Diffusion, câu lệnh đi qua bộ mã hóa chữ rồi vào bộ dự đoán nhiễu U-Net, một mạng nơ-ron chuyên đoán lượng nhiễu, để dẫn đường cho từng bước gỡ nhiễu.
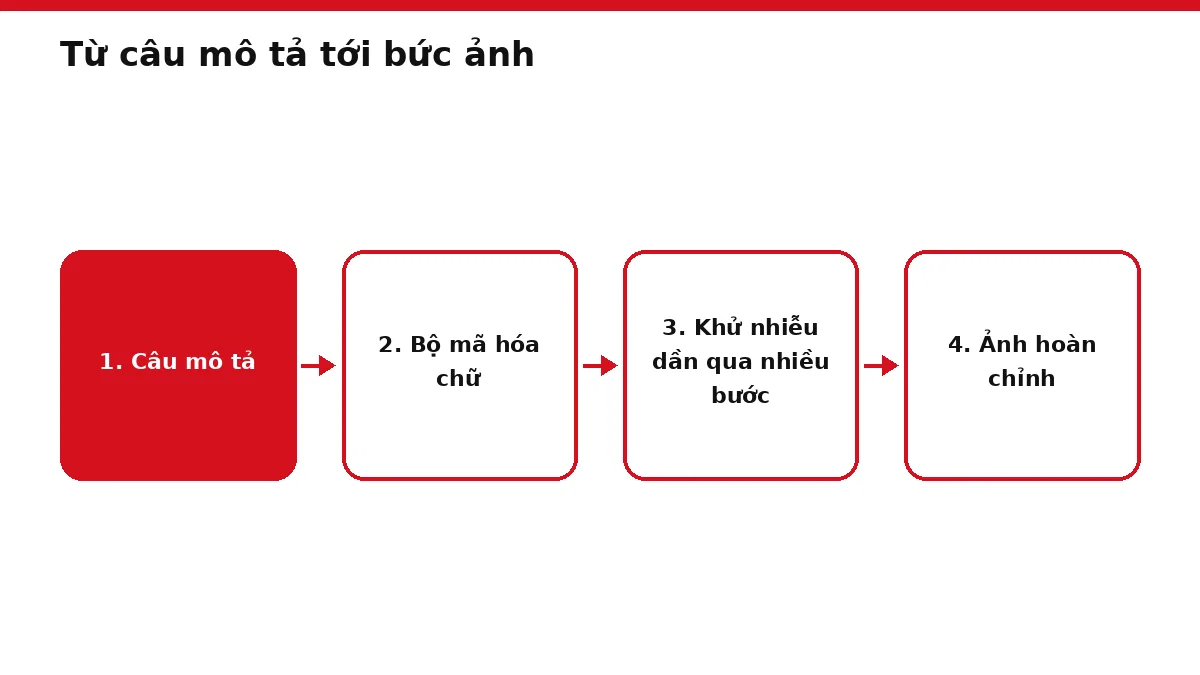
Mô hình học mối liên hệ giữa chữ và hình từ dữ liệu huấn luyện
Mô hình học cách nối chữ với hình bằng cách xem hàng trăm triệu tới hàng tỷ cặp ảnh và chú thích. Từ đó, nó biết cụm từ nào thường đi với hình dạng, màu sắc và bố cục nào. Dữ liệu huấn luyện là những bức ảnh kèm dòng chữ mô tả, thu thập từ internet.
CLIP được huấn luyện trên 400 triệu cặp ảnh và chữ, với bài tập đoán chú thích nào đi với ảnh nào. Bộ LAION-5B, công bố tháng 10/2022, có 5,85 tỷ cặp ảnh và chữ đã lọc bằng CLIP. Trong đó, 2,32 tỷ cặp là tiếng Anh. Theo kho mã của CompVis, Stable Diffusion được huấn luyện trên ảnh 512 × 512 pixel lấy từ một phần của LAION-5B.
Bộ LAION-5B lớn gần gấp 15 lần dữ liệu huấn luyện của CLIP.
Quy mô dữ liệu huấn luyện ảnh và chữ
Xem số liệu
| Đơn vị: tỷ cặp ảnh và chữ | Giá trị |
|---|---|
| CLIP | 0,4 |
| LAION-5B phần tiếng Anh | 2,32 |
| LAION-5B toàn bộ | 5,85 |
Bộ mã hóa chữ đổi câu mô tả thành một dãy số, giống như đổi một câu thành mã để máy so được với ảnh. Mô hình chỉ biết những gì có trong dữ liệu, nên dữ liệu lệch thì ảnh cũng lệch.
Thẻ mô hình Stable Diffusion v1-4, tức bản tự giới thiệu của mô hình, cho biết nó chủ yếu học trên chú thích tiếng Anh. Mô hình thường lấy văn hóa da trắng và phương Tây làm mặc định. Vì vậy, trang phục, món ăn hay phong cảnh Việt Nam có thể bị vẽ kém chính xác hơn.
Mô hình khuếch tán và GAN tạo ảnh khác nhau ra sao?
Mô hình khuếch tán (diffusion model) tạo ảnh bằng cách khử nhiễu dần qua nhiều bước. Mạng đối nghịch tạo sinh (GAN) thì cho hai mạng thi nhau: một mạng tạo ảnh, một mạng chấm thật giả.
Ian J. Goodfellow và cộng sự mô tả GAN trong một bài báo năm 2014. Mạng tạo (generator) sinh mẫu giả giống dữ liệu thật. Mạng phân biệt (discriminator) tìm cách nhận ra mẫu nào là giả.
Mô hình khuếch tán làm việc theo kiểu "phủ nhiễu rồi gỡ nhiễu". Theo AWS, bước phủ nhiễu, gọi là khuếch tán thuận, thêm dần nhiễu Gauss, tức nhiễu ngẫu nhiên dạng hạt, cho tới khi ảnh chỉ còn nhiễu. Bước gỡ nhiễu, gọi là khuếch tán ngược, đoán lượng nhiễu rồi trừ dần qua một số bước định sẵn. Khi tạo ảnh mới, mô hình bắt đầu từ một khối nhiễu và chỉ chạy bước gỡ.
Năm 2020, bài báo DDPM của Jonathan Ho và cộng sự cho thấy mô hình khuếch tán tạo được ảnh chất lượng cao. Trên bộ ảnh mẫu LSUN cỡ 256 × 256 pixel, chất lượng ảnh của nhóm ngang mô hình ProgressiveGAN.
Bài báo của nhóm Rombach đưa việc khử nhiễu vào không gian tiềm ẩn, tức một bản nén nhỏ hơn của ảnh. Cách này giảm đáng kể chi phí tính toán mà vẫn giữ chi tiết. Các lớp chú ý chéo (cross-attention) trong mô hình cho phép điều khiển ảnh bằng chữ.
Theo AWS, bộ mã hóa của Stable Diffusion nén ảnh 512 × 512 pixel thành bản 64 × 64. Mỗi cạnh ảnh vì thế nhỏ đi 8 lần.
Hướng mới hơn dùng kiến trúc transformer, một kiểu mạng nơ-ron khác. Tháng 3/2024, bài báo của Patrick Esser và cộng sự dùng trọng số, tức các thông số mô hình học được, riêng cho phần ảnh và phần chữ. Nhờ vậy, mô hình hiểu câu lệnh tốt hơn và viết chữ trong ảnh tốt hơn.
Một khác biệt ít được nhắc tới là rủi ro với dữ liệu huấn luyện: mô hình khuếch tán kém riêng tư hơn GAN nhiều.
| Tiêu chí | GAN | Mô hình khuếch tán |
|---|---|---|
| Cách tạo ảnh | Mạng tạo sinh mẫu, mạng phân biệt chấm thật giả | Bắt đầu từ nhiễu, trừ nhiễu dần qua nhiều bước |
| Bài báo nền | Goodfellow và cộng sự, 06/2014 | Ho và cộng sự, 06/2020; Rombach và cộng sự, 12/2021 |
| Mô hình tiêu biểu | ProgressiveGAN | Stable Diffusion |
| Rủi ro ghi nhớ dữ liệu huấn luyện | Thấp hơn | Cao hơn nhiều |
Nguồn: Goodfellow và cộng sự, Ho và cộng sự, Rombach và cộng sự, Carlini và cộng sự, AWS, kho mã CompVis.
Ảnh AI là ảnh mới hay được ghép từ ảnh có sẵn?
Ảnh AI là ảnh mới, được tính ra từ nhiễu chứ không ghép từ các mảnh ảnh có sẵn. Mỗi lần tạo, mô hình bắt đầu từ một khối nhiễu ngẫu nhiên và gỡ dần theo câu lệnh. Dù vậy, trong một số ít trường hợp, mô hình có thể tạo lại gần đúng một ảnh nó đã học.
Hiện tượng này gọi là "ghi nhớ" (memorization). Tháng 1/2023, Nicholas Carlini và 8 đồng tác giả công bố bài báo "Extracting Training Data from Diffusion Models". Nhóm viết rằng mô hình khuếch tán "memorize individual images from their training data and emit them at generation time". Câu này nghĩa là mô hình ghi nhớ từng ảnh trong dữ liệu huấn luyện rồi phát lại khi tạo ảnh.
Bằng cách tạo ảnh rồi lọc, nhóm trích được hơn một nghìn mẫu huấn luyện, từ ảnh chụp cá nhân tới logo đã đăng ký nhãn hiệu. Con số này là kết quả nhóm cố tình đi tìm, không có nghĩa ảnh AI nào cũng là bản sao. Nhưng có cả logo trong các mẫu trích được, nghĩa là ảnh AI có thể chứa thứ thuộc quyền của người khác. Vì vậy, ảnh dùng vào việc kinh doanh cần được kiểm tra kỹ trước khi đăng.
Ảnh do AI tạo đẹp đến đâu so với ảnh chụp thật?
Ảnh AI có thể đẹp ngang ảnh chụp chuyên nghiệp về ánh sáng và phong cách. Nhưng nó kém ảnh chụp thật ở độ chính xác của chi tiết, và không ghi lại một sự việc có thật. Đẹp là chuyện thẩm mỹ, còn đúng là chuyện ảnh có khớp với thực tế hay không.
Theo khảo sát VisualGPS của Getty Images công bố tháng 4/2024, 76% người được hỏi thấy mình sắp không còn phân biệt được ảnh có thật hay không. Ảnh AI không ghi lại sự việc nào, nên không có giá trị làm bằng chứng, dù trông thật đến đâu.
Những điểm ảnh AI làm tốt: ánh sáng, chất liệu và phong cách
Ảnh AI thường mạnh ở ba thứ: ánh sáng có chủ đích, bề mặt chất liệu và một phong cách hình ảnh nhất quán.
- Ánh sáng: câu lệnh có thể chọn kiểu sáng như giờ vàng, đèn phòng chụp hay ngược sáng. Cả bức ảnh được dựng theo kiểu sáng ấy.
- Chất liệu: câu lệnh có thể nêu da, vải hay kim loại để bề mặt trong ảnh trông như sờ được.
- Phong cách: câu lệnh có thể yêu cầu ảnh chụp, tranh màu nước hay ảnh dựng 3D. Cả loạt ảnh giữ được cùng một kiểu hình.
Chính những điểm mạnh này khiến ảnh giả dễ qua mắt người xem. Ánh sáng đẹp và bề mặt mịn khiến người xem nghĩ ảnh được chụp cẩn thận. Còn lỗi thì nằm ở những chi tiết ít ai soi kỹ.
4 lỗi ảnh AI vẫn hay mắc: bàn tay, chữ trong ảnh, logic bối cảnh, chi tiết nhỏ
Ảnh AI vẫn hay lộ lỗi ở bốn chỗ: bàn tay và hình người, chữ trong ảnh, logic bối cảnh và chi tiết nhỏ ở hậu cảnh. Chính nhóm làm Stable Diffusion v1-4 đã ghi hai lỗi trong thẻ mô hình: chữ trong ảnh và hình người.
| Lỗi | Biểu hiện | Tài liệu chính thức nói gì |
|---|---|---|
| Chữ trong ảnh | Chữ méo, sai chính tả hoặc không đọc được | Thẻ mô hình Stable Diffusion v1-4: mô hình không viết được chữ đọc rõ |
| Khuôn mặt và hình người | Hình người bị vẽ sai | Thẻ mô hình Stable Diffusion v1-4: khuôn mặt và hình người nói chung có thể không được tạo đúng |
Bàn tay là phần cơ thể nên soát đầu tiên. Với bối cảnh, hãy xem bóng đổ có cùng hướng với nguồn sáng không và vật thể có đứng đúng chỗ không. Với hậu cảnh, hãy xem biển hiệu và đồ vật phía sau có bị nhòe hay méo không.
Một số lỗi đang giảm. Stability AI cho biết Stable Diffusion 3 làm tốt hơn hẳn với câu lệnh có nhiều chủ thể và viết đúng chính tả hơn. Lúc thông báo, mô hình này mới mở danh sách chờ cho bản xem trước. Vì các mô hình mới sửa dần từng lỗi, bốn lỗi trên không đủ để kết luận ảnh thật hay giả.
Các dấu hiệu khác và cách kiểm tra từng bước nằm ở bài dấu hiệu nhận biết ảnh AI.
Công cụ tạo ảnh bằng AI phổ biến hiện nay
Công cụ tạo ảnh bằng AI hiện chia ba nhóm. Nhóm đầu nằm sẵn trong trợ lý AI hay hệ điều hành, như Gemini, mô hình ảnh GPT của OpenAI và Image Playground của Apple. Nhóm thứ hai chuyên tạo ảnh, như Adobe Firefly. Nhóm thứ ba là mô hình mở như Stable Diffusion. Bảng so sánh chi tiết nằm ở bài công cụ tạo ảnh bằng AI phổ biến.
Nhận biết ảnh do AI tạo ra bằng cách nào?
Muốn biết một ảnh có do AI tạo hay không, cần kết hợp ba cách: soi lỗi hình, kiểm tra thông tin nguồn gốc trong tệp và tra ngược nguồn ảnh. Không công cụ nào chính xác tuyệt đối. Chính Meta thừa nhận chưa nhận ra được mọi nội dung do AI tạo. Cách làm từng bước nằm ở bài cách nhận biết ảnh do AI tạo ra.
Gắn nhãn và thủy vân cho ảnh AI
Một ảnh AI có thể mang ba lớp dấu cho biết nguồn gốc: thủy vân ẩn trong điểm ảnh, siêu dữ liệu theo chuẩn C2PA và nhãn chữ cho người xem. Siêu dữ liệu (metadata) là phần thông tin đi kèm bên trong tệp ảnh. Hai lớp đầu thường do hãng gắn, còn lớp thứ ba nhiều khi người đăng phải tự làm.
| Lớp đánh dấu | Ai gắn | Người xem có thấy không | Dễ mất khi nào |
|---|---|---|---|
| Thủy vân ẩn (ví dụ SynthID) | Hãng tạo ảnh, ngay lúc tạo | Không, cần công cụ kiểm tra như Gemini hoặc SynthID Detector | Khi ảnh bị chỉnh sửa cực đoan. Theo Meta, người dùng có thể xóa dấu ẩn |
| Siêu dữ liệu C2PA (Content Credentials) | Phần mềm hoặc máy chụp hỗ trợ C2PA, ví dụ Adobe Firefly | Thấy khi bấm biểu tượng ghim Content Credentials hoặc dùng trang kiểm tra | Khi siêu dữ liệu bị xóa khỏi tệp |
| Nhãn chữ "Ảnh tạo bằng AI" | Người đăng ảnh, hoặc nền tảng như Meta với nhãn "Imagined with AI" | Có | Khi ảnh được tải về và đăng lại mà không kèm chú thích |
Thủy vân số trên ảnh AI là gì?
Thủy vân số (digital watermark) trên ảnh AI là một tín hiệu ẩn, nhúng vào chính các điểm ảnh ngay lúc tạo. Mắt thường không thấy nó, nhưng phần mềm của hãng đọc được để xác nhận ảnh do AI của hãng tạo. Khác với logo đóng ở góc ảnh, thủy vân này không nằm ở một chỗ để cắt bỏ.
Google DeepMind giới thiệu SynthID vào tháng 8/2023, ở dạng thử nghiệm, chỉ cho một số khách hàng dùng mô hình Imagen. Tháng 5/2025, Google cho biết đã có hơn 10 tỷ nội dung mang SynthID. Cùng lúc, SynthID đã mở rộng sang văn bản, âm thanh và video, gồm nội dung từ các mô hình Gemini, Imagen, Lyria và Veo. Theo tài liệu của Google, mọi ảnh tạo qua Gemini API đều có SynthID.
Theo trang SynthID, thủy vân được làm để chịu được cắt ảnh, thêm bộ lọc và nén có mất dữ liệu. Nhưng Google DeepMind cũng viết rằng SynthID "isn't foolproof against extreme image manipulations", tức không chống được mọi kiểu chỉnh ảnh cực đoan.
Người dùng có thể tải ảnh lên Gemini để hỏi ảnh có do AI của Google tạo hay sửa không. Cổng SynthID Detector ra mắt tháng 5/2025, ban đầu chỉ cho nhóm thử nghiệm sớm. Theo trang SynthID, cổng nay đã mở cho mọi người. Nó kiểm tra được tệp từ Google cùng các đối tác OpenAI, NVIDIA và Kakao.
Mỗi hãng có hệ thống riêng. Ví dụ, Meta đang phát triển Stable Signature, một cách gắn thủy vân ngay trong lúc tạo ảnh. Vì vậy, ảnh không có thủy vân chưa chắc là ảnh thật. Muốn kiểm tra ảnh có do AI tạo hay không, cần xem thủy vân cùng các dấu hiệu khác.
Chuẩn C2PA gắn nguồn gốc nội dung là gì?
C2PA là chuẩn kỹ thuật mở, gắn vào tệp một bản ghi cho biết nội dung được tạo và sửa ra sao. Chuẩn này do Liên minh về Nguồn gốc và Tính xác thực của Nội dung (Coalition for Content Provenance and Authenticity, C2PA) xây dựng. Theo thông cáo thành lập, liên minh ra mắt tháng 2/2021, do Adobe, Arm, BBC, Intel, Microsoft và Truepic sáng lập. Mục tiêu là chống thông tin sai lệch và gian lận nội dung trên mạng.
Theo trang giới thiệu, C2PA là dự án của Joint Development Foundation, một tổ chức phi lợi nhuận đặt tại Washington. Liên minh gộp hai sáng kiến trước đó là Content Authenticity Initiative và Project Origin. Trang chủ C2PA, cập nhật tháng 1/2026, ghi ban chỉ đạo có 11 tổ chức, trong đó có Amazon, Google, Meta, OpenAI, Sony và TikTok.
- Content Credentials: tên gọi của bản ghi nguồn gốc theo đặc tả do C2PA chủ trì. C2PA ví nó như "nhãn dinh dưỡng" của nội dung số. Ảnh có biểu tượng ghim Content Credentials là ảnh có thông tin nguồn gốc, bấm vào sẽ thấy cách tạo và lịch sử chỉnh sửa.
- Ai đang gắn: theo Adobe, mọi nội dung tạo bằng Firefly mặc định có Content Credentials. Theo Google, dòng Pixel 10 gắn Content Credentials vào mọi ảnh chụp bằng ứng dụng Pixel Camera. Ứng dụng này đạt Assurance Level 2, mức bảo mật cao nhất hiện có trong chương trình đánh giá của C2PA. Google Photos cũng gắn cho ảnh đã sửa bằng công cụ AI.
- Điểm yếu: bản ghi nằm trong siêu dữ liệu của tệp, nên mất khi siêu dữ liệu bị xóa.
- Cách xem: trang kiểm tra của Content Credentials cho xem bản ghi của một tệp. Địa chỉ contentcredentials.org/verify chuyển tới verify.contentauthenticity.org.
Châu Âu quy định gì về nội dung do AI tạo?
Điều 50 của Đạo luật AI châu Âu, tức Quy định (EU) 2024/1689, đặt ra hai nghĩa vụ chính. Hãng làm công cụ tạo ảnh phải đánh dấu ảnh ở dạng máy đọc được. Người đăng ảnh giả như thật (deepfake) phải công bố rằng ảnh do AI tạo hoặc sửa. Theo Ủy ban châu Âu, các nghĩa vụ này áp dụng từ ngày 02/08/2026, đúng ngày áp dụng ghi ở Điều 113.
Khoản 2 nói về bên cung cấp, tức hãng làm công cụ, kể cả hệ thống AI đa dụng. Hãng phải bảo đảm ảnh, âm thanh, video hay văn bản do AI làm ra mang dấu cho máy đọc được. Nhờ dấu này, phần mềm phát hiện được nội dung do AI tạo hoặc sửa.
Khoản 4 nói về bên triển khai, tức người hoặc doanh nghiệp dùng công cụ để đăng nội dung. Họ phải công bố khi ảnh, âm thanh hay video là nội dung giả như thật. Với tác phẩm rõ ràng mang tính nghệ thuật, sáng tạo, châm biếm hay hư cấu, chỉ cần công bố theo cách không cản trở việc thưởng thức. Khoản 5 buộc thông tin này đến với người xem chậm nhất ở lần tiếp xúc đầu tiên.
Gói sửa đổi Digital Omnibus về AI, đăng trên Công báo EU số OJ L 2026/1744, thêm khoản 4 vào Điều 111. Theo đó, hệ thống đã có mặt trên thị trường trước ngày 02/08/2026 phải đáp ứng khoản 2 của Điều 50 trước ngày 02/12/2026. Gia hạn này chỉ áp cho nghĩa vụ đánh dấu của bên cung cấp.
Vi phạm nghĩa vụ minh bạch có thể bị phạt tới 15 triệu euro, theo khoản 4 Điều 99. Với doanh nghiệp, mức phạt có thể tới 3% tổng doanh thu toàn cầu của năm tài chính trước, tùy mức nào cao hơn. Số tiền 15 triệu euro bằng khoảng 447 tỷ đồng. Theo khoản 6, doanh nghiệp nhỏ và vừa, kể cả công ty khởi nghiệp, chịu mức nào thấp hơn.
Tháng 6/2026, Ủy ban châu Âu công bố bản cuối của Bộ quy tắc thực hành về đánh dấu và gắn nhãn nội dung do AI tạo. Theo trang Bộ quy tắc, việc ký là tự nguyện, còn các yêu cầu của Điều 50 vẫn là nghĩa vụ pháp lý. Ủy ban và Hội đồng AI đã xác nhận ký bộ quy tắc là đủ để chứng minh tuân thủ. Tới cuối tháng 7/2026, khoảng 190 công ty và tổ chức đã ký.
Tháng 7/2026, Ủy ban công bố thêm hướng dẫn về nghĩa vụ minh bạch cho bên cung cấp và bên triển khai. Doanh nghiệp và người làm nội dung ở Việt Nam có khách hoặc người xem ở EU nên xem lại Điều 50 trước khi đăng ảnh AI.
Chỉ hệ thống đã có trên thị trường trước ngày 02/08/2026 mới được thêm thời hạn.
| Đối tượng | Nghĩa vụ | Thời hạn |
|---|---|---|
| Bên cung cấp hệ thống AI tạo ảnh không thuộc diện chuyển tiếp | Đánh dấu kết quả ở dạng máy đọc được (Điều 50 khoản 2) | Từ 02/08/2026 |
| Bên cung cấp hệ thống đã đưa ra thị trường trước 02/08/2026 | Làm các bước cần thiết để tuân thủ Điều 50 khoản 2 (Điều 111 khoản 4) | Trước 02/12/2026 |
| Bên triển khai đăng ảnh giả như thật | Công bố nội dung được tạo hoặc chỉnh sửa nhân tạo (Điều 50 khoản 4, 5) | Từ 02/08/2026 |
Ghi chú nguồn thế nào khi sử dụng ảnh do AI tạo?
Khi dùng ảnh do AI tạo, hãy ghi một dòng chú thích nêu rõ ảnh tạo bằng AI, tên công cụ và thời điểm tạo. Đồng thời, giữ nguyên siêu dữ liệu gốc của tệp.
- Viết chú thích ngay dưới ảnh theo mẫu: "Ảnh tạo bằng AI (tên công cụ), tháng/năm". Ủy ban châu Âu cũng đã thiết kế một bộ biểu tượng EU để bên triển khai dùng khi gắn nhãn nội dung do AI tạo.
- Giữ siêu dữ liệu khi chỉnh sửa và xuất tệp. Bộ mã của IPTC có ba mã cho ảnh có AI. Mã "trainedAlgorithmicMedia" dành cho ảnh tạo bằng AI tạo sinh, mã "compositeWithTrainedAlgorithmicMedia" cho ảnh sửa bằng AI tạo sinh. Mã "compositeSynthetic" dành cho ảnh ghép có ít nhất một thành phần do AI tạo. Theo Hướng dẫn người dùng AI tạo sinh của Adobe, bản cập nhật tháng 5/2026, người dùng không được xóa, sửa hay vô hiệu hóa Content Credentials.
- Dùng nhãn của nền tảng khi đăng. Meta gắn nhãn cho ảnh AI trên Facebook, Instagram và Threads khi phát hiện tín hiệu theo chuẩn của ngành. Với video và âm thanh, người dùng phải tự khai báo, nếu không có thể bị xử phạt.
Ghi nguồn đúng vẫn không thay cho việc xác định quyền sử dụng ảnh do AI tạo.
Ảnh do AI tạo ra có được bảo hộ bản quyền không?
Ở Mỹ, ảnh do AI tạo chỉ được bảo hộ bản quyền khi con người quyết định đủ phần biểu đạt của ảnh. Theo báo cáo Phần 2 của Văn phòng Bản quyền Mỹ công bố tháng 1/2025, chỉ viết câu lệnh thì chưa đủ để thành tác giả. Phần con người sắp xếp hay sửa đổi một cách sáng tạo vẫn có thể được bảo hộ. Phân tích đầy đủ nằm ở bài bản quyền với ảnh do AI tạo ra.
Dùng ảnh AI trong công việc hằng ngày
Ảnh AI hợp với những việc cần hình minh họa nhanh. Nó không hợp với chỗ người xem cần thấy sự thật: sản phẩm thật, sự kiện thật, người thật.
4 việc thường ngày có thể dùng ảnh AI: minh họa, ảnh sản phẩm, ảnh đại diện, bài giảng
Bốn việc thường ngày hợp với ảnh AI là ảnh minh họa cho bài viết, ảnh bối cảnh cho gian hàng trực tuyến, ảnh nền và hình đại diện. Việc thứ tư là hình cho bài giảng, tài liệu học tập. Riêng với gian hàng, bản thân món hàng vẫn phải là ảnh chụp thật.
| Việc | Ảnh AI làm được gì | Lưu ý |
|---|---|---|
| Ảnh minh họa cho bài viết | Hình cho ý tưởng trừu tượng, ảnh đầu bài | Gắn nhãn, không dùng cho tin về sự việc có thật |
| Ảnh sản phẩm cho gian hàng trực tuyến | Nền và bối cảnh quanh sản phẩm | Bản thân sản phẩm phải là ảnh chụp thật. Giữ thẻ đánh dấu ảnh AI theo chính sách của sàn |
| Ảnh nền và hình đại diện | Ảnh nền màn hình, hình đại diện kiểu hoạt hình hay minh họa | Không tạo từ ảnh người khác. Adobe cấm dùng AI tạo sinh để mạo danh người hoặc tổ chức khác |
| Bài giảng, tài liệu học tập | Hình cho slide. Image Playground có sẵn trong Keynote và Freeform | Soát lỗi khoa học trong hình trước khi dùng |
Người bán hàng qua Google Merchant Center phải giữ thẻ IPTC DigitalSourceType "trainedAlgorithmicMedia" trên mọi ảnh do AI tạo. Quy định này áp dụng cho ảnh chính (image_link), ảnh bổ sung (additional_image_link) và ảnh bối cảnh (lifestyle_image_link).
Ảnh AI được dùng trong quảng cáo và báo chí ra sao?
Quảng cáo dùng được ảnh AI cho bối cảnh và ý tưởng, miễn không khiến người xem hiểu sai. Báo chí thì chỉ nên dùng ảnh AI làm minh họa có ghi nhãn, không thay ảnh của sự kiện thật.
Trong quảng cáo, ảnh AI hợp với khâu phác thảo ý tưởng, dựng bối cảnh và làm nhiều biến thể cho cùng một thông điệp. Giới hạn nằm ở chính sách của hãng và ở luật. Chính sách AI tạo sinh của Google, bản sửa tháng 12/2024, cấm lừa đảo, gian lận và mạo danh người thật mà không nói rõ, để lừa dối. Ở EU, ảnh giả như thật trong quảng cáo cũng phải được công bố theo Điều 50 khoản 4.
Với báo chí và truyền thông, rủi ro lớn là người đọc tưởng ảnh minh họa là ảnh chụp sự kiện. Hướng dẫn tháng 7/2026 của Ủy ban châu Âu thêm một nghĩa vụ cho bên triển khai. Nội dung AI về vấn đề lợi ích công cộng phải được thông báo nếu không qua người rà soát hay biên tập. Chính sách của Google cũng cấm tuyên bố gây hiểu lầm về các tiến trình nhà nước hay dân chủ.
Độ phân giải, định dạng tải về và độ nét khi in của ảnh AI
Nhiều mô hình mặc định tạo ảnh khoảng 1 megapixel, tức chừng 1 triệu điểm ảnh. Cỡ quen thuộc là 1.024 × 1.024 pixel, tải về dạng PNG, JPEG hoặc WebP. Mức này đủ cho màn hình, còn in khổ lớn thì cần tính kỹ hơn. Theo công bố của hãng, Nano Banana 2.1 của Google tạo được ảnh tới mức 4K.
| Mô hình | Kích thước, độ phân giải | Ghi chú |
|---|---|---|
| Mô hình ảnh GPT của OpenAI | 1.024 × 1.024; 1.536 × 1.024; 1.024 × 1.536 pixel | Định dạng png, jpeg, webp. Nền trong suốt chỉ với png hoặc webp. Riêng gpt-image-2 và gpt-image-2.5 cho kích thước tùy chọn, mỗi cạnh chia hết cho 16, tỷ lệ khung từ 1:3 tới 3:1 |
| Nano Banana 2.1 (Gemini API) | 1K, 2K, 4K | Các mô hình ảnh Gemini 3 mặc định ở mức 1K |
| Gemini 3.1 Flash Image và Flash Lite Image | Flash Image có thêm mức 512 px. Flash Lite chỉ hỗ trợ 1K | Flash Lite có 10 tỷ lệ khung, từ 1:1 tới 21:9 |
| Stable Diffusion 3.5 | Large: 1 megapixel; Medium: 0,25–2 megapixel | Mô hình mở, chạy được trên máy riêng |
Ảnh vuông 1.024 × 1.024 pixel có khoảng 1,05 triệu điểm ảnh. Khổ ngang 1.536 × 1.024 pixel có khoảng 1,57 triệu điểm ảnh. Con số này nhiều hơn khổ vuông đúng 50%. Theo Stability AI, bản Medium của Stable Diffusion 3.5 tạo ảnh từ 0,25 tới 2 megapixel, nên cỡ ảnh tùy người dùng chọn.
Khi in, độ nét tùy mật độ điểm ảnh mà nhà in yêu cầu, tính bằng số điểm ảnh trên mỗi inch (ppi). Ảnh khoảng 1 megapixel hợp với màn hình và mạng xã hội. Muốn in, hãy hỏi nhà in mật độ họ cần, rồi chọn mức ảnh lớn nhất mà công cụ cho phép, ví dụ 2K hoặc 4K ở Nano Banana 2.1.
Phóng to bằng AI (upscale) làm tăng số điểm ảnh. Nhưng phần chi tiết thêm vào cũng do mô hình đoán ra, nên cần soát lỗi lại sau khi phóng.
Ảnh AI có thay được ảnh chụp sản phẩm và kho ảnh trả phí không?
Ảnh AI không thay được ảnh chụp sản phẩm, vì người mua cần thấy đúng món hàng. Nó chỉ thay được một phần kho ảnh trả phí, ở những hình minh họa chung chung. Ảnh sản phẩm phải đúng màu, đúng kích thước, đúng chi tiết. Ảnh do mô hình dựng có thể lệch ở chính những điểm đó, và khách dễ khiếu nại khi nhận hàng.
Kho ảnh trả phí vẫn mạnh ở ảnh người thật, sự kiện thật và giấy phép sử dụng đi kèm. Ảnh AI thì hợp với hình nền, họa tiết và ý tưởng chung. Cách dùng xen kẽ hợp lý là ảnh chụp thật cho sản phẩm, ảnh AI cho nền và minh họa, mỗi ảnh AI có nhãn riêng. Chuyện được dùng ảnh AI để bán hàng tới đâu nằm ở bài quyền sử dụng thương mại của ảnh AI.
Khách hàng phản ứng thế nào với ảnh do AI tạo?
Phần lớn người tiêu dùng muốn được biết ảnh nào do AI tạo. Theo khảo sát VisualGPS "Building Trust in the Age of AI" của Getty Images, gần 90% người được hỏi muốn biết một bức ảnh có do AI tạo hay không. Khảo sát hỏi hơn 30.000 người trưởng thành ở 25 quốc gia, trong đó có Úc, Brazil, Pháp, Đức, Nhật Bản, Singapore, Anh và Mỹ. Việc hỏi chia làm bốn đợt, mỗi đợt 7.500 người.
Gần như mọi người được hỏi coi ảnh và video chân thực là then chốt để tạo lòng tin.
Người tiêu dùng nói gì về ảnh chân thực
Xem số liệu
| Đơn vị: % | Giá trị |
|---|---|
| Ảnh và video chân thực là then chốt để tạo lòng tin | 98 |
| Điều quan trọng là ảnh phải chân thực | 87 |
| Sắp không phân biệt được ảnh có thật hay không | 76 |
Dùng ảnh AI như ảnh thật mà không ghi nhãn là đi ngược mong muốn của gần 9/10 người được hỏi. Ngược lại, một dòng nhãn rõ ràng trả lời đúng điều họ muốn biết.
Kiểm tra ảnh AI trước khi đăng công khai và những lưu ý cho công việc
Trước khi đăng công khai, kiểm tra ảnh AI theo sáu bước, đi từ lỗi dễ thấy tới việc dễ quên.
- Soát lỗi hình: hình người, bàn tay, bóng đổ và vật thể ở hậu cảnh.
- Soát chữ trong ảnh: biển hiệu, nhãn mác, chữ trên áo có đọc được và đúng chính tả không.
- Loại bỏ người thật và thương hiệu chưa được phép. Chính sách của Stability AI, có hiệu lực từ cuối tháng 9/2026, cấm mạo danh người khác khi không có sự đồng ý hoặc quyền hợp pháp.
- Kiểm tra độ nét theo mục đích dùng: màn hình, slide hay bản in.
- Giữ nguyên siêu dữ liệu và gắn nhãn cho ảnh.
- Đọc lại điều khoản của công cụ. Adobe cấm lan truyền nội dung sai lệch, gian lận hoặc lừa dối có thể gây hại ngoài đời thực. Stability AI cấm gây hiểu lầm về kết quả do AI tạo.
Ở chỗ làm, đừng đưa dữ liệu khách hàng, ảnh nội bộ hay ảnh của người khác vào công cụ khi chưa đọc chính sách dữ liệu của nó. Công ty, trường học có quy định riêng về ảnh AI thì làm theo quy định ấy. Người duyệt cuối nên là người chịu trách nhiệm về nội dung được đăng, không phải người vừa tạo ảnh.
Khi nào không nên dùng ảnh do AI tạo?
Không nên dùng ảnh do AI tạo khi ảnh có vai trò chứng minh một sự thật: tin tức, sự kiện, sản phẩm đang bán, người thật và giấy tờ.
- Ảnh minh họa tin thời sự và sự kiện có thật: người đọc dễ tưởng đó là ảnh chụp tại chỗ. Ở EU, ảnh giả như thật còn phải được công bố là nội dung tạo hoặc chỉnh sửa nhân tạo.
- Ảnh sản phẩm đang bán: người mua cần thấy đúng món hàng qua ảnh chụp thật.
- Ảnh có người thật khi chưa được người đó đồng ý: Google cấm ảnh thân mật không có sự đồng ý và cấm mạo danh người thật để lừa dối.
- Ảnh thẻ, ảnh hồ sơ, ảnh trên giấy tờ: những ảnh này phải khớp với khuôn mặt thật của người nộp.
- Nội dung y tế, pháp lý, khoa học cần chính xác tuyệt đối: một chi tiết sai trong hình có thể khiến người đọc hiểu sai nghiêm trọng.
Google có thể cho ngoại lệ vì lý do giáo dục, tư liệu, khoa học hoặc nghệ thuật. Nhưng đó là quyết định của hãng, không phải quyền mặc định của người dùng.
Tạo ảnh bằng AI ảnh hưởng thế nào đến nghề thiết kế?
AI tạo ảnh có thể đổi cách làm của nghề thiết kế, nhất là ở khâu phác thảo và làm biến thể. Người thiết kế vẫn giữ vai trò định hướng, chỉnh sửa và chịu trách nhiệm về sản phẩm cuối. Phân tích đầy đủ nằm ở bài AI ảnh hưởng thế nào đến nghề thiết kế.
Tạo ảnh bằng AI khác tạo video và tiêu tốn tài nguyên ra sao?
Tạo video bằng AI khó hơn tạo ảnh, vì mô hình phải giữ nhân vật và chuyển động khớp nhau qua nhiều khung hình liên tiếp. Vì vậy, tạo video tốn thời gian và sức tính toán hơn hẳn một bức ảnh tĩnh. Khác biệt giữa hai việc nằm ở bài tạo video bằng AI. Mỗi lần tạo ảnh cũng tốn điện và sức tính toán của máy chủ, chuyện này nằm ở bài tài nguyên mà AI tiêu tốn.
Mốc gần nhất cần theo dõi là ngày 02/12/2026. Đó là hạn để các công cụ tạo ảnh đã có mặt ở EU từ trước ngày 02/08/2026 đánh dấu ảnh cho máy đọc được. Các công cụ đang có mặt nằm ở bài các công cụ tạo ảnh bằng AI đang được dùng. Cách phân biệt ảnh AI với ảnh chụp thật nằm ở một bài riêng.
Cách đọc số liệu: Thông số kích thước, định dạng và chính sách của từng hãng lấy theo trang chính thức của hãng, tra cứu ngày 19/10/2026. Các điều khoản của Đạo luật AI châu Âu lấy theo trang AI Act Service Desk của Ủy ban châu Âu, tra cứu cùng ngày. Tiền phạt quy đổi sang đồng theo giá bán euro của Vietcombank lúc 8 giờ 2 phút cùng ngày, 29.808,42 đồng một euro.