Khi chọn công cụ, bạn nên xem năm điểm: kiểu đầu vào, độ dài clip, độ phân giải, thời gian chờ và nhãn nguồn gốc. Nhãn này gồm hình mờ ẩn và thông tin theo C2PA, một chuẩn mở ghi lại nguồn gốc của nội dung số.
Hướng dẫn cũ về dùng Sora 2 qua API, tức cổng để phần mềm gọi mô hình của OpenAI, không còn làm theo được. Videos API và mô hình Sora 2 bị gỡ khỏi API từ ngày 24/09/2026. OpenAI báo việc này ngày 24/03/2026 trên trang Deprecations của OpenAI, nơi hãng liệt kê các tính năng ngừng hỗ trợ. Thông báo không kèm mô hình thay thế.
AI tạo video là gì?
AI tạo video thuộc nhóm AI tạo sinh, tức loại AI làm ra nội dung mới, cùng họ với AI tạo ảnh. Nó sinh ra chuỗi khung hình (frame) chuyển động mới. Mỗi khung hình là một ảnh tĩnh, nối với các ảnh kế tiếp thành video. Theo bài giải thích của Runway, mô hình sinh điểm ảnh từ các mẫu hình đã học trong video.
Leah Retta, tác giả bài của Runway, tóm ý này trong một câu: "AI video models don't film anything. They predict frames, starting from noise". Nghĩa là mô hình không quay gì cả. Nó dự đoán từng khung hình, bắt đầu từ nhiễu.
Đầu ra là clip ngắn, có thể kèm âm thanh tùy mô hình. Theo tài liệu Veo, mọi mô hình Veo trong Gemini API, cổng dành cho nhà phát triển của Google, đều tạo âm thanh cùng lúc với video. Trang giới thiệu Veo của Google DeepMind cho biết Veo 3.1 tạo được hiệu ứng âm thanh, tiếng nền và lời thoại.
Hai cái tên tiêu biểu hiện nay là Veo của Google và Runway. Các bản Veo 3.1 được cập nhật gần nhất vào tháng 01/2026 và tháng 03/2026. Runway dùng mô hình Gen-4.5, hãng công bố ngày 01/12/2025. Sora 2 của OpenAI thì không còn trên API.
Ba kiểu đầu vào: văn bản, ảnh và video có sẵn
Công cụ AI tạo video nhận ba kiểu đầu vào chính: câu lệnh văn bản, ảnh tĩnh và video có sẵn. Theo Runway và tài liệu Veo, mỗi kiểu cho bạn một mức kiểm soát khác nhau.
- Văn bản sang video: mô hình chỉ dựa vào câu lệnh (prompt), tức đoạn chữ mô tả cảnh bạn muốn có, nên tự quyết phần lớn hình ảnh. Veo nhận câu lệnh dài tối đa 1.024 token, tức đơn vị chữ mô hình dùng để đếm độ dài. Runway Gen-4.5 nhận tối đa 1.000 ký tự. Ví dụ: tả một con đường ven biển lúc hoàng hôn để có cảnh nền cho bài thuyết trình.
- Ảnh sang video: ảnh làm khung đầu, khung cuối hoặc cả hai, nên cảnh mở đầu hay kết thúc đúng như ảnh bạn đưa vào. Trong Veo, ảnh đầu vào là khung hình đầu tiên. Veo 3.1 và Veo 3.1 Fast còn nhận tối đa 3 ảnh tham chiếu cho cảnh, nhân vật hoặc vật thể. Ví dụ: làm cho ảnh chụp một món đồ thủ công xoay nhẹ.
- Video sang video: đổi phong cách hoặc chỉnh cảnh quay có sẵn. Mô hình Aleph 2.0 của Runway làm việc này với video đầu vào dài 2 đến 30 giây. Video đó phải có từ 30 khung hình/giây trở xuống. Ví dụ: chuyển đoạn quay đường phố ban ngày sang phong cách hoạt hình.
AI hỗ trợ dựng phim khác AI tạo video ra sao?
AI hỗ trợ dựng phim xử lý cảnh quay có sẵn, còn AI tạo video sinh ra cảnh quay mới chưa từng tồn tại. Premiere Pro của Adobe là ví dụ cho nhóm thứ nhất. Theo thông cáo của Adobe, các tính năng AI của phần mềm này phát hành chính thức ngày 02/04/2025. Khác biệt lớn nhất giữa hai nhóm là có sinh ra khung hình mới hay không.
| Tiêu chí | AI hỗ trợ dựng phim | AI tạo video |
|---|---|---|
| Đầu vào | Cảnh quay và âm thanh có sẵn | Câu lệnh, ảnh tĩnh hoặc video có sẵn |
| Việc chính | Tìm clip, dịch phụ đề, chuyển màu, kéo dài clip | Sinh chuỗi khung hình mới theo yêu cầu |
| Có sinh khung hình mới không | Chỉ ở vài tính năng, như Generative Extend thêm khung hình vào cuối clip | Có, toàn bộ khung hình đều mới |
| Ví dụ tính năng | Media Intelligence tìm clip theo nội dung; Caption Translation dịch phụ đề sang 27 ngôn ngữ; Color Management tự chuyển màu cảnh quay sang chuẩn HDR và SDR | Kéo dài cảnh, thêm và xóa vật thể, tạo từ ảnh tham chiếu (Veo 3.1 của Google); tạo video từ văn bản hoặc ảnh (Gen-4.5 của Runway) |
| Rủi ro giả mạo | Phần lớn hình vẫn là cảnh quay thật; Adobe gắn Content Credentials, tức bản ghi nguồn gốc nội dung, cho kết quả Generative Extend | Có thể dựng cảnh người thật chưa từng xảy ra, nên các hãng cấm mạo danh |
Ranh giới giữa hai nhóm đang mờ dần. Generative Extend chạy bằng Firefly Video Model, thêm khung hình và âm thanh vào cuối clip để giữ cảnh lâu hơn. Còn Google DeepMind giới thiệu Veo 3.1 có tính năng thêm và xóa vật thể trong video. Vì vậy, bạn nên xét từng tính năng. Phần khung hình do AI sinh ra là phần cần ghi nhãn và kiểm tra kỹ.
Người dẫn ảo do AI tạo là gì?
Người dẫn ảo do AI tạo là nhân vật hình người do AI dựng nên để trình bày một kịch bản có sẵn. Khác với video sinh cảnh tự do, trọng tâm của nó là lời nói của nhân vật, không phải bối cảnh. Trang đạo đức AI của Synthesia, một hãng làm người dẫn ảo, nêu các ứng dụng chính. Đó là video đào tạo kỹ thuật và tuân thủ, video bán hàng, video quy trình chuẩn và video hội nhập nhân viên mới. Hãng làm các video này bằng hơn 140 ngôn ngữ.
Rủi ro lớn nhất là deepfake, tức video giả hình ảnh hoặc giọng nói của người thật. Synthesia coi sự đồng ý của người được dựng thành người dẫn ảo là phần cốt lõi khi thực thi chính sách. Hãng kiểm duyệt nội dung ngay lúc tạo và gắn nhãn theo Điều 50 Đạo luật AI của EU. Runway cấm dùng hình người khác khi chưa được phép, còn Google cấm mạo danh người khác để đánh lừa. Hình mờ ẩn và chuẩn C2PA là hai cách gắn nhãn nguồn gốc, giúp người xem biết video do AI tạo.
AI tạo video hoạt động như thế nào?
AI tạo video dùng mô hình khuếch tán (diffusion), theo mô tả của Runway. Mô hình học cách biến nhiễu ngẫu nhiên thành khung hình theo câu lệnh, qua nhiều bước khử nhiễu liên tiếp. Khi huấn luyện, người ta thêm nhiễu vào video để mô hình học đoán phần nhiễu đó. Lúc tạo video mới, mô hình làm ngược lại quá trình này.
Câu lệnh đi qua bộ mã hóa văn bản (text encoder), phần chuyển chữ thành tín hiệu số để điều khiển từng bước khử nhiễu. Tạo video tốn tài nguyên hơn tạo ảnh vì phải làm ra rất nhiều khung hình. Theo Runway, một clip 5 giây có khoảng 120 khung hình. Con số này tính ở tốc độ 24 khung hình/giây. Mọi mô hình Veo cũng chạy ở 24 khung hình/giây. Một clip Veo 8 giây vì thế có 192 khung hình phải khớp nhau.
Video Veo tạo ra còn đi qua bộ lọc an toàn và bước kiểm tra ghi nhớ. Bước này soát xem video có lặp lại nội dung mô hình đã học hay không. Theo Google DeepMind, bước kiểm tra này dùng để giảm rủi ro về quyền riêng tư, bản quyền và thiên lệch.
Mô hình khuếch tán biến nhiễu thành khung hình ra sao?
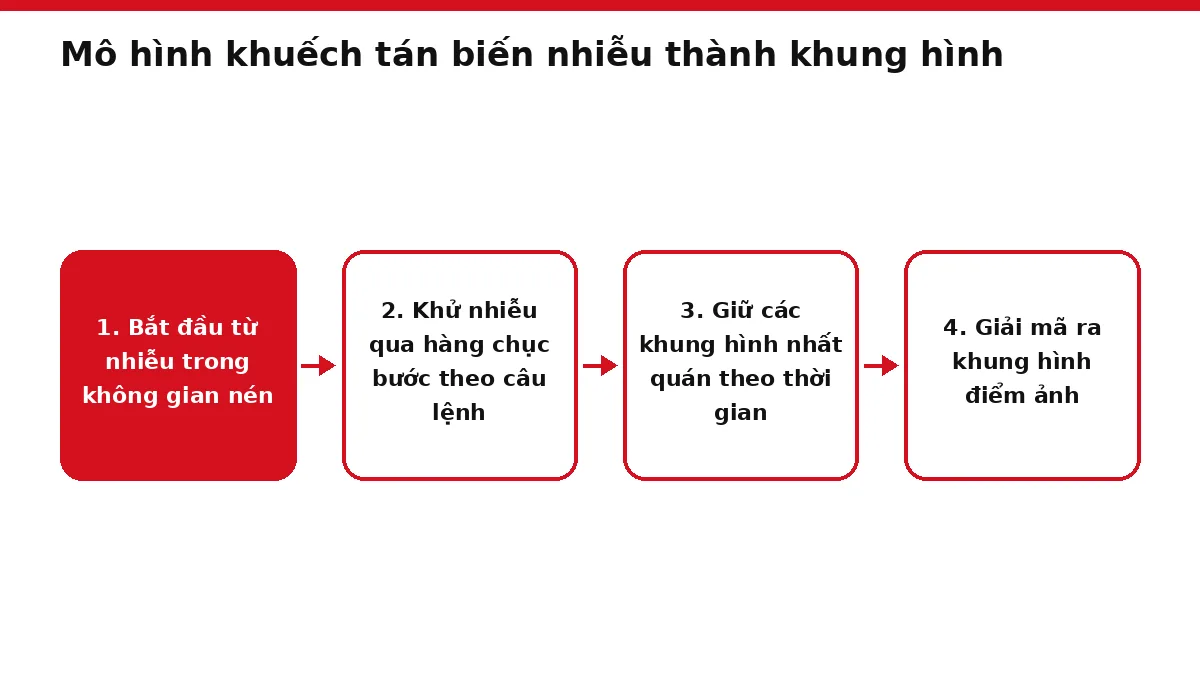
Mô hình khuếch tán bắt đầu từ một khối nhiễu ngẫu nhiên. Qua mỗi bước, nó trừ bớt một phần nhiễu, cho tới khi còn lại chuỗi khung hình khớp với câu lệnh. Nhiễu giống lớp hạt lấm tấm trên ảnh chụp thiếu sáng, chỉ khác là lúc đầu cả khung hình đều là hạt. Runway chia quy trình thành bốn bước.
- Bắt đầu từ nhiễu trong không gian nén (latent space), tức dạng thu gọn của video. Mô hình làm việc trên dạng nén này thay vì trên từng điểm ảnh, tới bước cuối mới giải mã ra khung hình.
- Khử nhiễu qua hàng chục bước, mỗi bước theo tín hiệu từ câu lệnh đã mã hóa. Ít bước thì tạo nhanh hơn, còn nhiều bước thì đổi tốc độ lấy độ trung thực.
- Xử lý cùng lúc không gian và thời gian bằng transformer không gian – thời gian (spatiotemporal transformer). Khối mạng này theo dõi quan hệ giữa các vùng ảnh trong một khung và qua các khung liền nhau. Runway gọi cách kết hợp khuếch tán với transformer là latent diffusion transformer.
- Giải mã từ không gian nén ra khung hình điểm ảnh. Sau bước này, các mô hình bổ sung có thể nâng độ phân giải, số khung hình và độ mượt của chuyển động.
Cả quá trình đi từ một khối nhiễu tới chuỗi khung hình rõ nét.
Vì sao giữ các khung hình liền mạch là việc khó nhất?
Giữ liền mạch khó nhất vì mô hình phải giữ nhân vật, vật thể và ánh sáng nhất quán qua hàng trăm khung hình. Trong khi đó, khung nào cũng sinh ra từ nhiễu. Sự nhất quán theo thời gian nghĩa là mỗi vật giữ nguyên hình dạng, vị trí và màu sắc từ khung này sang khung sau. Runway nêu ba biểu hiện khi việc này thất bại:
- Vật thể biến mất hoặc bất ngờ xuất hiện giữa các khung hình, một giới hạn Runway tự nêu khi công bố Gen-4.5.
- Chữ trên màn hình xê dịch từ khung này sang khung khác.
- Hình phản chiếu không khớp với vật thật.
Theo Runway, chuyển động càng dài và phức tạp thì lỗi nhìn thấy được càng dễ xuất hiện. Đi cùng giới hạn này là thực tế mỗi lần tạo hiện chỉ cho ra vài giây video.
AI tạo video làm được gì hiện nay?
Tính đến tháng 10/2026, AI tạo video làm được clip ngắn một cảnh từ câu lệnh hoặc từ ảnh. Các mô hình Veo còn tạo kèm âm thanh, và một số công cụ chỉnh được cảnh quay có sẵn. Khi bạn đưa ảnh làm khung đầu, cảnh mở đầu đúng như ảnh, nên kết quả dễ kiểm soát hơn khi chỉ dùng câu lệnh.
Theo công bố của hãng, các mô hình người dùng truy cập được đã làm được năm việc:
- Tạo clip từ câu lệnh với nhiều phong cách: Runway cho biết Gen-4.5 bám câu lệnh, có nhân vật biểu cảm và phong cách từ chân thực tới hoạt hình. Ví dụ: cảnh minh họa cho một bài giảng.
- Tạo âm thanh cùng video: mọi mô hình Veo trên Gemini API đều làm việc này. Ví dụ: tiếng sóng đi kèm cảnh biển. Riêng lời nói tự nhiên, nhất quán của Veo 3.1, nhất là các đoạn nói ngắn, vẫn đang được phát triển, theo Google DeepMind.
- Nối khung đầu với khung cuối: Veo 3.1, Veo 3.1 Lite và Veo 3 đều có chế độ này, gọi là nội suy. Ví dụ: chuyển từ ảnh nụ hoa sang ảnh hoa nở.
- Giữ cảnh, nhân vật, vật thể theo ảnh tham chiếu: Veo 3.1 tạo video từ các thành phần trong ảnh bạn đưa vào. Ví dụ: cùng một chiếc ô tô đồ chơi ở nhiều góc máy.
- Chỉnh cảnh quay có sẵn: Aleph 2.0 của Runway chỉnh video bằng khung hình chính (keyframe), tức khung định sẵn trạng thái của cảnh. Trang giới thiệu Veo 3.1 nêu tính năng mở rộng khung hình (outpainting), tức vẽ thêm phần cảnh ra ngoài khung gốc. Ví dụ: đổi video dọc thành video ngang.
Con người vẫn phải tham gia ở nhiều khâu. Theo tài liệu Veo, tham số seed của Veo 3, tức con số khởi tạo dùng để lặp lại kết quả, chỉ cải thiện nhẹ. Nó không bảo đảm cho ra video y hệt lần trước. Vì vậy, bạn thường phải tạo nhiều bản, chọn bản dùng được, rồi tự dựng, chỉnh màu và thêm chữ.
Video trình diễn của hãng khác gì kết quả người dùng nhận được?
Trang giới thiệu của hãng nêu khả năng cao nhất của mô hình, còn tài liệu kỹ thuật ghi điều kiện để đạt được khả năng đó. Với Veo 3.1, trang giới thiệu ghi đầu ra 4K. Tài liệu cho nhà phát triển lại ghi 4K chỉ có khi clip dài 8 giây.
| Tiêu chí | Trang giới thiệu Veo 3.1 (Google DeepMind) | Tài liệu Veo cho nhà phát triển (Gemini API) |
|---|---|---|
| Độ phân giải | Ghi đầu ra 1080p và 4K | Mặc định 720p; 1080p và 4K chỉ khi clip dài 8 giây |
| Kéo dài cảnh | Giới thiệu tính năng kéo dài cảnh | Chỉ có ở Veo 3.1 và Veo 3.1 Fast, đầu ra 720p |
| Tình trạng phát hành | Có trên Gemini, Google Flow, Google Vids, Google AI Studio và Gemini API | Ghi là bản xem trước (Preview) |
| Ngày của số liệu | Phần đo chuẩn ghi cập nhật lần cuối tháng 10/2025 | Trang cập nhật ngày 08/10/2026 |
| Giới hạn hãng tự nêu | Lời nói tự nhiên, nhất quán vẫn đang được phát triển | Chưa hỗ trợ câu lệnh tham chiếu hoặc suy luận qua nhiều video |
Khi xem một video trình diễn hay trang giới thiệu, bạn nên tìm ba dấu hiệu. Đó là nhãn bản xem trước (Preview), điều kiện đi kèm con số như độ dài clip, và ngày cập nhật số liệu. Sau đó, bạn nên so với tài liệu cho nhà phát triển của cùng hãng. Runway cũng tự nêu ba giới hạn của Gen-4.5 ngay trong bài công bố, nên đọc bài này cùng video mẫu.
Giới hạn độ dài và chất lượng video AI
Video AI hiện vướng năm giới hạn chính: độ dài mỗi lần tạo, độ phân giải, độ ổn định của chuyển động, thời gian chờ và thời hạn lưu tệp. Các giới hạn này thay đổi theo từng phiên bản mô hình. Riêng Gemini API đã có ba bản Veo 3.1 là Veo 3.1, Veo 3.1 Fast và Veo 3.1 Lite, còn Veo 3 bị ghi là ngừng hỗ trợ.
Video do AI tạo thường dài tối đa bao nhiêu?
Mỗi lần tạo, công cụ phổ biến chỉ cho ra clip vài giây. Theo công bố của hãng, Veo 3.1 tạo được clip tối đa 8 giây mỗi lần. Với Runway Gen-4.5, tài liệu API của Runway ghi mức tối đa 10 giây. Video dài hơn phải ghép từ nhiều clip hoặc dùng tính năng kéo dài.
| Công cụ | Phiên bản | Độ dài tối đa mỗi lần tạo | Có kéo dài hoặc nối cảnh không | Tháng cập nhật |
|---|---|---|---|---|
| Veo (Google) | Veo 3.1, Veo 3.1 Fast | 8 giây (chọn 4, 6 hoặc 8 giây) | Có: mỗi lần thêm 7 giây, tối đa 20 lần | 01/2026 |
| Veo (Google) | Veo 3.1 Lite | 8 giây (chọn 4, 6 hoặc 8 giây) | Không có tính năng kéo dài; có chế độ khung đầu – khung cuối | 03/2026 |
| Veo (Google) | Veo 3 (ngừng hỗ trợ) | 8 giây | Không có tính năng kéo dài; có chế độ khung đầu – khung cuối | 07/2025 |
| Runway | Gen-4.5 (API) | 10 giây (chọn từ 2 tới 10 giây) | Ngày 01/12/2025, Runway cho biết sẽ đưa chế độ Keyframes lên Gen-4.5 | Mô hình công bố 12/2025; tài liệu API truy cập 10/2026 |
| OpenAI | Sora 2 | Bị gỡ khỏi API từ 24/09/2026 | Không còn dùng qua API | Thông báo 03/2026 |
Nguồn: tài liệu Veo của Google, tài liệu API của Runway, trang Deprecations của OpenAI.
Tính năng kéo dài của Veo nối tiếp một video do chính Veo tạo, mỗi lần thêm 7 giây và làm được tối đa 20 lần. Sau đủ 20 lần, clip dài thêm 140 giây. Cộng với clip gốc 8 giây, tổng tối đa là 148 giây.
Video đưa vào kéo dài phải dài từ 141 giây trở xuống và ở 720p. Vì thế, phần kéo dài không giữ được độ nét 1080p hay 4K. Tỷ lệ khung hình của video này phải là 16:9 hoặc 9:16.
Con số độ dài trên trang giới thiệu có thể đi kèm điều kiện riêng, nên bạn cần so với tài liệu kỹ thuật trước khi tin. Bài so sánh các công cụ tạo video AI giúp bạn chọn công cụ theo độ dài clip.
Độ phân giải và chất lượng của video AI ra sao?
Theo công bố của hãng, Veo 3.1 cho video từ 720p tới 4K tùy độ dài clip. Runway Gen-4.5 ghi kích thước theo điểm ảnh, như 1280:720 khi tạo từ văn bản. Muốn nét hơn mức gốc, video phải qua bước nâng cấp sau khi tạo.
| Công cụ | Phiên bản | Độ phân giải | Tỷ lệ khung hình hỗ trợ | Số khung hình mỗi giây |
|---|---|---|---|---|
| Veo (Google) | Veo 3.1, Veo 3.1 Fast | 720p (mặc định); 1080p và 4K chỉ với clip 8 giây | 16:9 (mặc định), 9:16 | 24 |
| Veo (Google) | Veo 3.1 Lite | 720p (mặc định); 1080p chỉ với clip 8 giây; không có 4K | 16:9 (mặc định), 9:16 | 24 |
| Runway | Gen-4.5 (API) | Kích thước theo điểm ảnh 1280:720 hoặc 720:1280 khi tạo từ văn bản | Tạo từ ảnh có thêm 1104:832, 960:960, 832:1104, 1584:672 | Có công cụ riêng Enhance Frame Rate để tăng số khung hình |
Độ phân giải chỉ cho biết số điểm ảnh. Nó không cho biết ngón tay hay chữ trong hình có đúng hay không. Độ phân giải gốc là mức mô hình tạo ra. Theo Runway, sau bước giải mã, các mô hình bổ sung có thể nâng độ phân giải và số khung hình lên. Công cụ Enhance Frame Rate của Runway nhận video đầu vào dài tới 300 giây.
Vì sao video AI hay bị lỗi chuyển động?
Video AI hay lỗi chuyển động vì mô hình chỉ đoán điểm ảnh từ mẫu hình đã học trong video. Nó không quay một cảnh thật, nơi có lực và cấu trúc cơ thể thật. Vì vậy, mô hình dễ sai ở chỗ cần hiểu bàn tay cầm nắm ra sao hay vật nào tác động lên vật nào. Runway nêu các lỗi điển hình:
- Tay và mặt biến dạng, như thừa ngón tay. Runway gọi tay và mặt là trường hợp khó nhất.
- Hiệu ứng đôi khi xảy ra trước nguyên nhân, ví dụ một vật vỡ trước khi bị va chạm.
- Hành động thành công nhiều bất thường, ví dụ cú ném nào trong cảnh cũng trúng đích.
Ở mức người dùng, bạn có thể giảm lỗi bằng ba cách: chọn chuyển động đơn giản, giữ clip ngắn và dùng ảnh làm khung đầu.
Thời gian chờ để tạo xong một đoạn video AI là bao lâu?
Theo tài liệu Veo, một đoạn video Veo mất ít nhất 11 giây để tạo xong. Vào giờ cao điểm, khi máy chủ tải cao, thời gian chờ có thể lên tới 6 phút. Ba yếu tố làm thời gian chờ thực tế dài thêm:
- Tải của máy chủ: tài liệu Veo gắn mức chờ dài nhất với giờ cao điểm.
- Số bước khử nhiễu: theo Runway, ít bước thì tạo nhanh hơn, nhiều bước thì đổi tốc độ lấy độ trung thực.
- Số lần tạo lại: video bị bộ lọc chặn hoặc có lỗi phải tạo lại. Riêng với Veo, video bị chặn vì lý do liên quan tới âm thanh thì không bị tính phí.
Vì vậy, thời gian để có một clip dùng được thường gấp nhiều lần thời gian chờ của một lần tạo. Mỗi lần tạo lại là thêm một lần chờ.
Video AI tải về nặng bao nhiêu?
Dung lượng video AI tải về phụ thuộc vào độ dài, độ phân giải và cách nén của tệp. Ví dụ, lấy một clip 8 giây ở 4K. Nếu cùng định dạng tệp, clip này nặng hơn một clip 4 giây ở 720p.
Mã mẫu trong tài liệu Veo lưu kết quả thành tệp .mp4. Theo tài liệu API lõi của Runway, định dạng mặc định là .mp4 nén theo chuẩn H.264, một chuẩn nén video phổ biến. Gen-4.5 và Aleph 2.0 còn xuất được tệp ProRes dạng .mov và chuỗi ảnh PNG đóng gói .zip.
Với người dùng, thời hạn lưu tệp là con số cần nhớ. Google lưu video Veo trên máy chủ 2 ngày rồi xóa. Nếu bạn dùng video đó để kéo dài, bộ đếm 2 ngày bắt đầu lại. Với Runway, đường link tải video chỉ tồn tại tạm thời và hết hạn trong 24 đến 48 giờ. Hãng yêu cầu người dùng tải về và lưu vào kho riêng.
5 việc AI tạo video chưa làm được
Tính đến tháng 10/2026, AI tạo video vẫn chưa thay được một ê-kíp làm phim ở năm việc.
- Giữ một nhân vật nhất quán qua nhiều cảnh: mỗi yêu cầu Veo chỉ tạo một video. Tài liệu Veo cũng ghi mô hình chưa hỗ trợ tham chiếu hoặc suy luận qua nhiều video. Cách gần nhất hiện nay là dùng ảnh tham chiếu cho nhân vật.
- Làm phim dài liền mạch theo kịch bản: Runway xếp clip dài hơn vào hướng phát triển tương lai. Tính năng kéo dài của Veo dừng ở tổng 148 giây.
- Hiển thị chữ trong hình ổn định: theo Runway, chữ vẫn xê dịch giữa các khung hình. Vì vậy, biển hiệu hay chữ vẽ sẵn trong cảnh khó dùng ngay.
- Mô phỏng đúng vật lý trong cảnh phức tạp: cảnh có nhiều va chạm nối tiếp đòi hỏi đúng thứ tự nguyên nhân và kết quả. Đây đúng là chỗ Runway tự nhận Gen-4.5 còn sai.
- Cho người dùng chỉnh chính xác từng cử động: seed của Veo 3 không bảo đảm lặp lại kết quả. Vì vậy, khó sửa một chi tiết mà giữ nguyên phần còn lại. Trang giới thiệu Veo 3.1 của Google DeepMind nêu khả năng điều khiển nhân vật, chuyển động và camera.
Bài AI tạo video ảnh hưởng thế nào đến nghề làm phim nói về tác động của các giới hạn này lên người làm nghề.
Công cụ tạo video chặn những loại nội dung nào?
Mỗi hãng chặn nội dung theo chính sách sử dụng của mình, và bộ lọc kiểm tra cả câu lệnh lẫn video đầu ra. Theo tài liệu Veo, câu lệnh vi phạm hướng dẫn sử dụng bị chặn từ đầu, còn video tạo ra phải qua bộ lọc an toàn.
Theo chính sách sử dụng của Runway cập nhật ngày 06/03/2026, hãng có thể khóa tài khoản vì bất kỳ vi phạm nào. Nội dung nghi xâm hại tình dục trẻ em bị báo cho Trung tâm Quốc gia về Trẻ em Mất tích và Bị bóc lột của Mỹ (NCMEC). Tài khoản liên quan bị khóa vô thời hạn. Người dùng có thể khiếu nại qua email của hãng.
Chính sách cấm sử dụng AI tạo sinh của Google, sửa đổi ngày 17/12/2024, cấm lách các biện pháp chống lạm dụng hay bộ lọc an toàn.
4 nhóm nội dung bị chặn theo chính sách của các hãng
Chính sách của Runway và Google cùng chặn bốn nhóm nội dung chính, dù mỗi hãng chia nhóm theo cách riêng.
| Nhóm nội dung | Ví dụ được nêu trong chính sách | Hãng có quy định |
|---|---|---|
| Nội dung tình dục, nhất là nội dung liên quan tới trẻ vị thành niên | Tài liệu xâm hại tình dục trẻ em, dụ dỗ trẻ, khỏa thân người lớn, hình ảnh thân mật không đồng thuận | Runway (nhóm An toàn trẻ em; nhóm Nội dung tình dục và khỏa thân), Google |
| Giả mạo người thật, deepfake không có sự đồng ý, lừa đảo | Dùng hình, video, âm thanh của người khác khi chưa được phép; mạo danh người còn sống hay đã mất; lừa đảo | Runway (nhóm Quyền của người khác; nhóm Nội dung gây hiểu lầm), Google |
| Bạo lực, khủng bố, thù ghét | Khủng bố, cực đoan bạo lực, cảnh máu me, phát ngôn thù ghét, quấy rối, cổ xúy tự hại | Runway (nhóm Bạo lực và máu me; nhóm Hành vi thù ghét, quấy rối và tự hại), Google |
| Thông tin sai về bầu cử và vi phạm sở hữu trí tuệ | Tuyên bố sai về bầu cử và quy trình dân chủ (Google); vi phạm sở hữu trí tuệ, bắt chước phong cách nghệ sĩ còn sống (Runway) | Google (bầu cử và quy trình dân chủ); Runway và Google (sở hữu trí tuệ) |
Hai hãng khác nhau ở cách chia. Runway liệt kê bảy nhóm, trong đó có một nhóm riêng cho nhân vật và thế giới trò chơi. Nhóm này cấm nhân vật dựa trên mặt hoặc giọng trẻ vị thành niên, và nhân vật đưa lời khuyên y tế, pháp lý, tài chính. Google gom thành bốn nhóm, trong đó có nhóm xâm phạm an ninh như thư rác, lừa đảo qua mạng, mã độc. Google cũng có thể cho ngoại lệ với mục đích giáo dục, tư liệu, khoa học, nghệ thuật, hoặc khi lợi ích công cộng lớn hơn tác hại.
Veo còn có tham số kiểm soát việc tạo hình người. Với Veo 3.1, chế độ tạo từ văn bản và kéo dài cho phép mọi hình người. Chế độ tạo từ ảnh, nội suy và ảnh tham chiếu chỉ cho phép người lớn. Ở EU, Anh, Thụy Sĩ và khu vực Trung Đông – Bắc Phi, Veo chỉ cho tạo hình người lớn.
Hình mờ và chuẩn C2PA gắn nguồn gốc cho video AI thế nào?
Các hãng gắn nguồn gốc cho video AI bằng hai cách: hình mờ ẩn trong hình và thông tin theo chuẩn C2PA đính kèm trong tệp. Theo tài liệu Veo, video Veo mang hình mờ SynthID và kiểm tra được trên nền tảng xác minh SynthID.
- Hình mờ ẩn (watermark): dấu nhận dạng mắt thường không thấy. Theo trang SynthID của Google DeepMind, SynthID gắn hình mờ vào video ngay lúc tạo. Hình mờ được thiết kế để không làm giảm chất lượng và chịu được cắt khung, thêm bộ lọc, đổi số khung hình hay nén mất dữ liệu. Công cụ SynthID Detector ra mắt năm 2025, kiểm tra nội dung có do AI của Google hoặc đối tác như OpenAI, NVIDIA, Kakao tạo ra hay không.
- Siêu dữ liệu C2PA: siêu dữ liệu là thông tin đi kèm tệp, như công cụ đã tạo ra video và các lần chỉnh sửa. C2PA (Liên minh về nguồn gốc và tính xác thực của nội dung) là dự án của Joint Development Foundation, một tổ chức phi lợi nhuận ở Washington. Dự án này gộp nỗ lực của Content Authenticity Initiative và Project Origin. Ban chỉ đạo gồm Adobe, Amazon, BBC, Google, Meta, Microsoft, OpenAI, Sony, TikTok và một số tổ chức khác. Bản ghi theo chuẩn này gọi là Content Credentials, có chữ ký mật mã để lộ ra việc can thiệp.
Cơ chế này có giới hạn. Theo phần hỏi đáp của C2PA, bản kê nguồn gốc có thể bị tách khỏi tệp, và siêu dữ liệu có thể bị gỡ, vô tình hoặc cố ý. Khi đó, liên kết mềm như hình mờ ẩn hay dấu vân tay nội dung giúp tìm lại Content Credentials. Vì vậy, một video không có thông tin C2PA chưa chắc là video quay thật. Bài kiểm tra nguồn gốc video hướng dẫn tự kiểm tra một video cụ thể.
5 lưu ý khi dùng video AI cho công việc
Dùng video AI cho công việc, bạn cần giữ năm nguyên tắc để tránh rủi ro pháp lý và mất uy tín.
- Đọc điều khoản về quyền sử dụng thương mại. Theo mục 4.4 của điều khoản sử dụng của Runway bản tháng 9/2026, hãng không nhận quyền sở hữu đầu vào và đầu ra. Runway cũng không hạn chế dùng thương mại nếu bạn tuân thủ thỏa thuận. Đổi lại, bạn cấp cho Runway giấy phép không độc quyền, không hủy ngang, vĩnh viễn và toàn cầu. Runway có thể dùng dữ liệu đó để huấn luyện mô hình. Điều khoản bổ sung Gemini API bản tháng 4/2026 ghi Google không nhận quyền sở hữu nội dung tạo ra, nhưng có thể tạo nội dung tương tự cho người khác. Video có được bảo hộ bản quyền hay không lại là chuyện khác, tùy luật từng nước.
- Không dùng hình ảnh hay giọng nói của người thật khi chưa có sự đồng ý. Theo mục 3.1 và 4.2 của điều khoản Runway, người dùng hoàn toàn chịu trách nhiệm về hình, video, âm thanh mình gửi lên. Họ phải có đủ quyền và giấy phép với nội dung đó. Ví dụ: nhân viên văn phòng không dựng đồng nghiệp đọc thông báo nội bộ khi người đó chưa đồng ý.
- Ghi nhãn nội dung do AI tạo theo quy định của nền tảng. Trang trợ giúp YouTube yêu cầu công bố video AI trông như thật khi tải lên, qua mục cài đặt AI use. Người nhiều lần không công bố có thể bị gỡ nội dung hoặc bị đình chỉ khỏi Chương trình Đối tác YouTube. Tại EU, Ủy ban châu Âu cho biết quy tắc minh bạch của Đạo luật AI có hiệu lực từ tháng 08/2026. Deepfake phải được ghi nhãn rõ, dễ thấy. Ví dụ: chủ cửa hàng nhỏ đăng video giới thiệu có cảnh chân thực do AI tạo cần bật nhãn trước khi đăng.
- Kiểm tra lỗi hình và lỗi thông tin trước khi đăng. Theo Google, người dùng chịu trách nhiệm về việc dùng nội dung tạo ra, kể cả khi người được chia sẻ dùng lại nội dung đó. Ví dụ: sinh viên dùng clip AI trong bài thuyết trình cần xem lại tay, chữ và thứ tự hành động trong từng cảnh.
- Không đưa dữ liệu nhạy cảm vào câu lệnh và tải tệp về sớm. Với bản không trả phí của Gemini API, Google có thể dùng đầu vào, đầu ra để cải thiện sản phẩm, và người duyệt có thể đọc chúng. Hãng dặn không gửi thông tin nhạy cảm, bí mật hay thông tin cá nhân. Tệp video chỉ được lưu trong thời gian ngắn, nên cần tải về ngay. Học sinh ở Việt Nam chưa đủ 18 tuổi cần lưu ý: điều khoản của Google chỉ cho người từ 18 tuổi trở lên dùng Gemini API.
Công cụ tạo video bằng AI phổ biến
Các công cụ tạo video AI khác nhau về độ dài clip, độ phân giải, kiểu đầu vào và điều khoản sử dụng. Google có Veo 3.1, Veo 3.1 Fast và Veo 3.1 Lite. Runway có Gen-4.5, Gen-4 Turbo và Aleph 2.0, còn API của Runway có thêm Seedance, Kling và WAN. Bài công cụ tạo video bằng AI phổ biến so từng công cụ chi tiết.
Làm sao nhận biết một video do AI tạo ra?
Có ba cách nhận ra video do AI tạo. Cách thứ nhất là để ý lỗi hình ở tay, chữ và chuyển động. Cách thứ hai là xem nhãn YouTube hay TikTok tự gắn khi đọc được siêu dữ liệu C2PA. Cách thứ ba là dùng công cụ kiểm tra hình mờ SynthID. Chỉ nhìn bằng mắt thì chưa đủ. Trong nghiên cứu của Runway, 1.043 người xem các clip dài 5 giây. Họ nhận đúng 57,1% số lần, và chỉ khoảng 9,5% người nhận biết đáng tin cậy. Bài cách nhận biết video do AI tạo ra hướng dẫn từng bước.
Bản quyền với video do AI tạo ra được xử lý thế nào?
Quyền với video do AI tạo phụ thuộc vào luật của từng nước và điều khoản của từng công cụ. Ngày 29/01/2025, Cục Bản quyền Mỹ cho biết đầu ra của AI tạo sinh chỉ được bảo hộ khi con người quyết định đủ yếu tố biểu đạt. Chỉ đưa câu lệnh thì không đủ. Bài bản quyền với video do AI tạo ra phân tích chi tiết hơn.
Veo 3.1 trên Gemini API vẫn mang nhãn bản xem trước. Độ dài clip, độ phân giải và thời hạn lưu tệp vì thế có thể đổi ở bản phát hành sau. Muốn chọn công cụ, bạn có thể đối chiếu các công cụ tạo video hiện có. Gặp một clip đáng ngờ, bạn có thể tự kiểm tra một video nghi do AI tạo.
Cách đọc số liệu: Thông số trong bài ghi theo công bố của hãng, lấy từ tài liệu Veo của Google cập nhật ngày 08/10/2026 và tài liệu API của Runway truy cập ngày 19/10/2026. Phần cơ chế dựa vào bài giải thích của Runway đăng tháng 8/2026.