Bốn từ hay gặp khi đọc về mô hình ngôn ngữ lớn:
- Token: mẩu chữ nhỏ mà mô hình xử lý, có thể là một từ, một phần của từ hoặc một ký tự.
- Tham số (parameter): các biến bên trong quyết định cách mô hình xử lý dữ liệu và đưa ra dự đoán. GPT-3 của OpenAI, ra năm 2020, có 175 tỷ tham số.
- Cửa sổ ngữ cảnh (context window): số token tối đa mà mô hình dùng được trong một lần làm việc.
- Huấn luyện (training): quá trình mô hình đo sai số dự đoán của mình rồi chỉnh dần các tham số cho bớt sai.
Mô hình ngôn ngữ lớn là gì?
Mô hình ngôn ngữ lớn học từ hàng tỷ tới hàng nghìn tỷ từ để đoán và viết tiếp văn bản. Chỉ từ một việc là đoán chữ tiếp theo, nó trả lời câu hỏi, tóm tắt, dịch và soạn nội dung theo yêu cầu.
Theo IBM, LLM học theo cách tự giám sát trên văn bản chưa gán nhãn. Nghĩa là mô hình lấy chính văn bản làm đề bài: che chữ tiếp theo rồi tập đoán, không cần người gán nhãn. Khi viết, mô hình đoán từng token tiếp theo, lặp đi lặp lại cho tới hết câu trả lời. Amazon Web Services (AWS) gọi LLM là mô hình học sâu rất lớn, được tiền huấn luyện trên lượng dữ liệu khổng lồ.
Muốn đoán đúng chữ tiếp theo trên khối văn bản đủ lớn, mô hình phải học được quy luật của ngôn ngữ. Vì vậy cùng một năng lực dùng được cho nhiều việc. Theo AWS, mô hình trả lời được một yêu cầu không kèm ví dụ nào (zero-shot), dù độ chính xác lúc cao lúc thấp. Khi được đưa vài ví dụ (few-shot), nó làm tốt hơn hẳn trong một lĩnh vực.
Mô hình khác chatbot. Mô hình là phần lõi tính toán, còn chatbot hay tính năng tìm kiếm là sản phẩm bọc ngoài, thêm giao diện, công cụ và quy định riêng. Ví dụ, theo thông báo của Google ngày 14/05/2024, AI Overviews trên Google Search chạy bằng một mô hình Gemini tùy biến riêng cho Search. Tương tự, Anthropic phát triển họ mô hình Claude, còn claude.ai là giao diện chat để người dùng trò chuyện với các mô hình đó.
Chữ "lớn" trong mô hình ngôn ngữ lớn nói về điều gì?
Chữ "lớn" nói về ba thứ cùng lúc: số tham số của mô hình, lượng dữ liệu huấn luyện và sức tính toán cần để huấn luyện nó.
- Tham số: có thể hình dung như các núm vặn được chỉnh dần trong lúc học. Theo AWS, tham số gồm trọng số (weight), độ lệch (bias) và vector nhúng (embedding). Theo IBM, mô hình lớn có thể có hàng tỷ, thậm chí hàng nghìn tỷ tham số.
- Dữ liệu: quy mô được đo bằng token. Theo NVIDIA, GPT-3 được huấn luyện trên 300 tỷ token.
- Sức tính toán: huấn luyện chạy trên cả cụm GPU đặt trong trung tâm dữ liệu.
Theo công bố của Meta ngày 05/04/2025, Llama 4 Scout có tổng 109 tỷ tham số. Mỗi lần xử lý, chỉ 17 tỷ trong số đó làm việc, gọi là tham số hoạt động. Llama 4 Maverick cũng có 17 tỷ tham số hoạt động, trên tổng 400 tỷ. Bản lớn nhất, Llama 4 Behemoth, có 288 tỷ tham số hoạt động trên tổng gần 2 nghìn tỷ. Lúc công bố, Behemoth vẫn đang được huấn luyện và chưa cho tải.
Lớn hơn không đồng nghĩa với tốt hơn trong mọi việc. Trong bài báo InstructGPT của OpenAI, người đánh giá ưa câu trả lời của một mô hình 1,3 tỷ tham số hơn GPT-3 với 175 tỷ tham số. Mô hình được ưa hơn lại nhỏ hơn khoảng 100 lần. Vì vậy mô hình nhỏ vẫn có chỗ dùng riêng.
Mô hình ngôn ngữ lớn đứng ở đâu trong AI, học máy và học sâu?
Mô hình ngôn ngữ lớn là một nhánh của học sâu, học sâu là một nhánh của học máy, và học máy là một nhánh của trí tuệ nhân tạo. Mỗi tầng hẹp hơn tầng chứa nó.
- Trí tuệ nhân tạo (AI): tên chung cho các hệ thống máy tính làm được việc vốn cần trí óc con người.
- Học máy (machine learning): máy tự rút quy luật từ dữ liệu, thay vì được lập trình từng bước.
- Học sâu (deep learning): học máy dùng mạng nơ-ron nhiều lớp. Cả IBM lẫn AWS đều xếp LLM vào nhóm này.
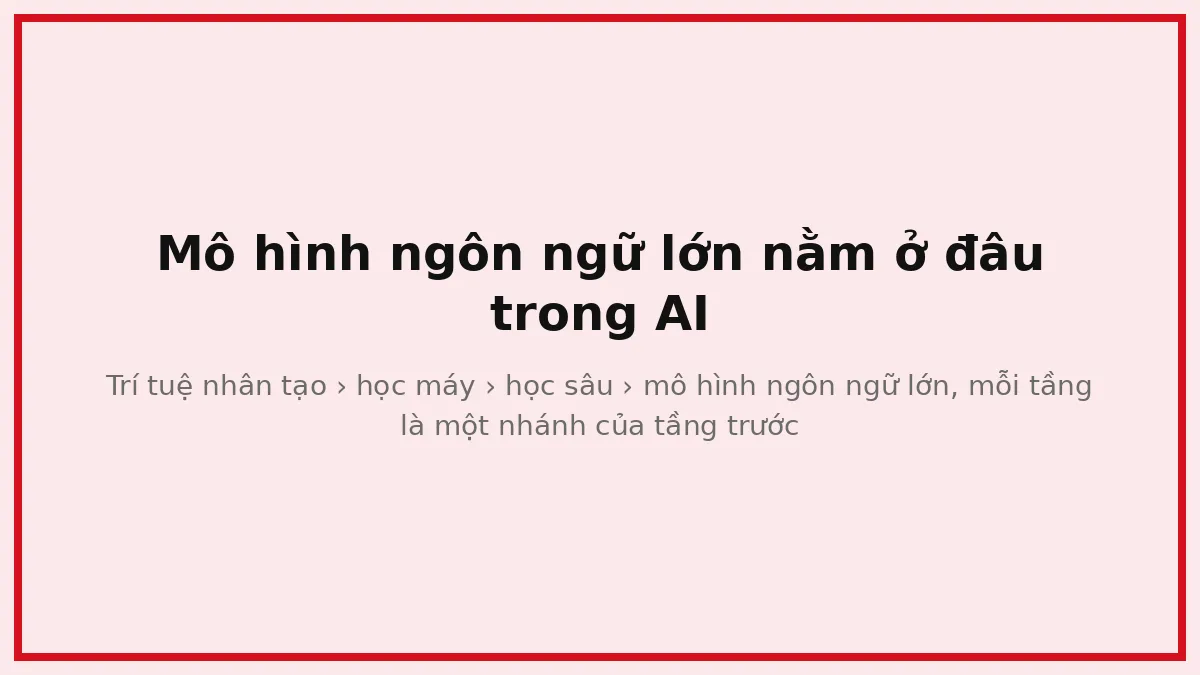
AI tạo sinh (generative AI) là nhóm mô hình làm ra nội dung mới. LLM là phần làm việc với ngôn ngữ của nhóm ấy. Nhiều người gọi chung mọi thứ là "AI". Với chatbot viết chữ, gọi đúng tên LLM giúp bạn tách nó khỏi công cụ tạo ảnh hay hệ thống phân loại hình ảnh.
Mô hình ngôn ngữ lớn hoạt động như thế nào?
Mô hình chia câu chữ thành token, tính xác suất cho từng token có thể đứng tiếp theo, rồi chọn một token. Nó lặp lại vòng ấy cho tới khi viết xong câu trả lời. Hai phần then chốt của quy trình là token và kiến trúc transformer.
Token và cách mô hình đoán chữ tiếp theo
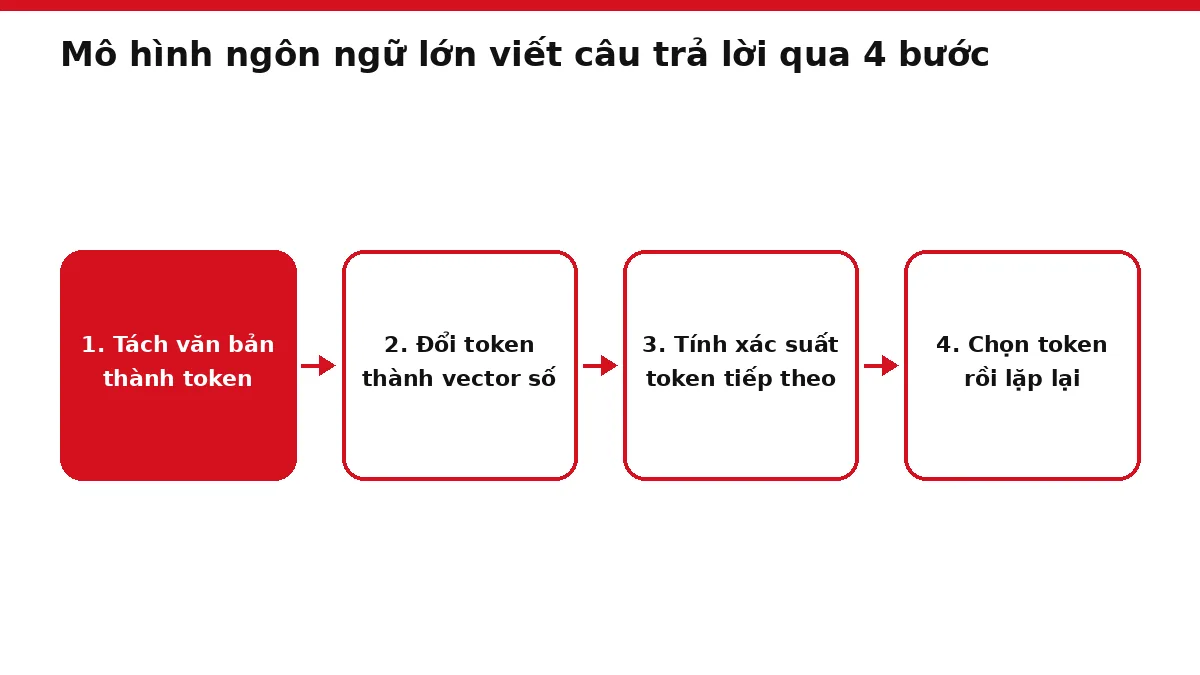
Token là mẩu chữ nhỏ nhất mà mô hình xử lý: một từ, một phần của từ hoặc một ký tự. Mô hình viết câu trả lời bằng cách đoán lần lượt từng token. Theo IBM, quy trình gồm bốn bước:
- Tách văn bản đầu vào thành token.
- Đổi mỗi token thành một vector số gọi là embedding. Theo AWS, nhờ vậy các từ gần nghĩa có dãy số gần nhau.
- Tính xác suất cho các token có thể đứng tiếp theo.
- Chọn một token, nối vào câu rồi lặp lại từ bước 3 cho tới khi xong câu trả lời.
Bước chọn token dựa trên xác suất, nên cùng một câu hỏi có thể cho ra câu trả lời khác nhau. Theo IBM, các thông số nhiệt độ (temperature), top-k và top-p chỉnh độ ngẫu nhiên khi chọn. Nói cách khác, chúng quyết định mô hình có chịu chọn cả những token ít khả năng hơn hay không.
Độ dài của một token thay đổi theo hãng. Theo tài liệu về token của Google, với các mô hình Gemini, 1 token dài khoảng 4 ký tự. Còn 100 token vào khoảng 60–80 từ tiếng Anh. Với tiếng Việt có dấu, cùng một ý có thể tốn số token khác tiếng Anh, tùy bộ tách token của từng hãng. Chênh lệch ấy đi thẳng vào chi phí, vì phí dùng mô hình tính theo token.
Kiến trúc transformer và cơ chế chú ý
Transformer là kiến trúc mạng nơ-ron, tức khung thiết kế của mạng, mà các mô hình ngôn ngữ lớn chạy trên đó. Cơ chế chú ý (attention) của nó cho phép mô hình xét các từ trong câu cùng lúc, để biết từ nào liên quan tới từ nào.
Kiến trúc này ra đời trong bài báo "Attention Is All You Need", nộp lên arXiv tháng 6/2017. Bài có 8 tác giả đứng tên, mở đầu là Ashish Vaswani. Theo phần tóm tắt, transformer chỉ dựa vào cơ chế chú ý, không dùng hai kỹ thuật cũ là hồi quy và tích chập. Nhờ vậy nó dễ chạy song song hơn và cần ít thời gian huấn luyện hơn. Trong thử nghiệm dịch máy, mô hình đạt 28,4 điểm BLEU, thang đo chất lượng bản dịch, trên bộ WMT 2014 Anh–Đức. Với bộ Anh–Pháp, nó đạt 41,8 điểm sau 3,5 ngày huấn luyện. Lần huấn luyện này chạy trên 8 GPU.
Theo IBM, điểm mới then chốt là tự chú ý (self-attention): mô hình tính mối liên hệ giữa các token, kể cả những token nằm xa nhau trong câu. Ví dụ: với chữ "đường", trong câu "đường phố đông xe", mô hình chú ý tới "phố" và "xe". Trong câu "cho thêm đường vào cà phê", nó chú ý tới "cà phê". Nhờ vậy mô hình phân biệt được hai nghĩa.
Theo AWS, khác với mạng nơ-ron hồi quy (RNN) có trước, transformer xử lý cả chuỗi chữ song song. Nhờ vậy mô hình huấn luyện được trên GPU, và thời gian huấn luyện ngắn lại.
Theo IBM, Word2Vec và GloVe đã biến từ thành vector từ thập niên 2010, trước khi có transformer. Sau đó đến BERT năm 2018. Năm 2019, GPT-2 đã viết được các đoạn văn mạch lạc. Gần đây còn có các kiến trúc thay thế như Mamba, một dạng mô hình không gian trạng thái, và LLM khuếch tán (diffusion).
3 loại mô hình ngôn ngữ lớn người dùng hay gặp
Người dùng hay gặp 3 loại: mô hình chỉ xử lý văn bản, mô hình đa phương thức và mô hình biết suy luận. Chúng khác nhau ở dữ liệu nhận vào và cách trả lời. Một mô hình mới có thể vừa đa phương thức vừa biết suy luận, như Gemini 4 Argon của Google.
| Loại mô hình | Nhận vào và trả ra | Ví dụ dòng mô hình (cập nhật ngày 19/10/2026) |
|---|---|---|
| Chỉ xử lý văn bản | Nhận chữ, trả chữ | Mô hình nhẹ cho việc chỉ cần chữ, khối lượng lớn: Claude Haiku 5.5, gpt-6-luna (cả hai cũng nhận được ảnh) |
| Đa phương thức | Nhận chữ và ảnh, có mô hình nhận cả video, âm thanh, PDF; trả về chữ | Các mô hình Claude hiện hành, các mô hình mới nhất của OpenAI, Gemini 4 Argon, Llama 4 Scout |
| Biết suy luận | Tự lập các bước suy nghĩ trước khi đưa câu trả lời cuối | Gemini 4 Argon, gpt-6-astra, gpt-6.1-sol, Claude Opus 5.5 |
Mô hình chỉ xử lý văn bản
Mô hình chỉ xử lý văn bản nhận chữ và trả lại chữ. Đây là dạng gốc của mô hình ngôn ngữ lớn. Nó hợp với viết, tóm tắt, dịch và lập trình, những việc mà cả đầu vào lẫn đầu ra đều là chữ.
Các mô hình hiện hành đều nhận được ảnh, nhưng nhiều việc hằng ngày chỉ cần chữ. Khi đó mô hình nhẹ hợp lý hơn về tốc độ và giá. Anthropic dành Claude Haiku 5.5 cho việc khối lượng lớn, cần phản hồi nhanh như phân loại, trích xuất và định tuyến, tức chuyển yêu cầu tới đúng nơi xử lý. OpenAI gọi gpt-6-luna là mô hình tiết kiệm nhất cho việc khối lượng lớn.
Nhỏ hơn nữa là mô hình ngôn ngữ nhỏ. Theo IBM, loại này có ít tham số hơn nhiều nên hợp với thiết bị nhỏ. Đó cũng là hướng của mô hình nhỏ chạy ngay trên điện thoại và máy tính.
Mô hình đa phương thức là gì?
Mô hình đa phương thức (multimodal) là mô hình ngôn ngữ lớn hiểu được nhiều dạng dữ liệu cùng lúc. Nó nhận chữ, hình ảnh, âm thanh, video và trả lời bằng chữ. Theo trang mô hình của từng hãng, mọi mô hình Claude hiện hành và các mô hình mới nhất của OpenAI đều nhận chữ và ảnh. Gemini 4 Argon nhận thêm video, âm thanh và PDF.
Mô hình "đọc" ảnh bằng cách đổi ảnh thành token, giống như với chữ. Theo Google, một ảnh có cả hai chiều từ 384 pixel trở xuống tính 258 token. Ảnh lớn hơn được cắt thành các ô vuông cạnh 768 pixel, mỗi ô cũng tính 258 token. Âm thanh tính 32 token mỗi giây, nên một phút ghi âm vào khoảng 1.920 token.
Ba cách dùng quen thuộc với người Việt:
- Chụp hóa đơn hoặc trang tài liệu rồi nhờ mô hình tóm tắt, trích các con số chính.
- Gửi ảnh một bài tập để hỏi cách giải từng bước.
- Gửi đoạn ghi âm cuộc họp để mô hình chép lại các ý chính.
Dù nhận nhiều dạng dữ liệu, các mô hình này chỉ trả về chữ. Đó là điểm khác với công cụ tạo ảnh hay tạo video.
Mô hình biết suy luận (reasoning) là gì?
Mô hình biết suy luận tự lập một chuỗi bước suy nghĩ trước khi đưa ra câu trả lời cuối. Nhờ vậy nó giải bài toán phức tạp theo từng bước nhỏ. Theo IBM, loại này được tinh chỉnh bằng học tăng cường, tức học dần qua phản hồi về kết quả. Cách học ấy dạy nó chia bài toán thành các bước, gọi là dấu vết suy luận (reasoning trace).
Suy nghĩ trước khi trả lời nghĩa là mô hình viết thêm token suy luận, và số token ấy cũng mất tiền. Theo Anthropic, token suy nghĩ của Claude tính tiền như token đầu ra. Khi dùng qua API, tức cổng để phần mềm gọi thẳng tới mô hình, người dùng đặt một mức trần gọi là max_tokens cho mỗi câu trả lời. Token suy nghĩ nằm trong mức trần này và cũng tính vào giới hạn tốc độ. Google gọi Gemini 4 Argon là mô hình suy luận chủ lực của mình.
Cách chọn mức suy luận khác nhau giữa các hãng: OpenAI chia nhiều mức nhất, còn Anthropic để mô hình tự điều chỉnh.
| Hãng | Mô hình | Cách chọn mức suy luận (theo công bố của hãng, cập nhật ngày 19/10/2026) |
|---|---|---|
| OpenAI | gpt-6-astra, gpt-6.1-sol | 5 mức: low, medium, high, xhigh, max |
| OpenAI | gpt-6-luna | 5 mức trên, thêm mức none |
| Anthropic | Claude Fable 5.1, Claude Opus 5.5 | Suy nghĩ thích ứng, luôn bật |
| Anthropic | Claude Sonnet 5.5, Claude Haiku 5.5 | Suy nghĩ thích ứng (adaptive) |
| Gemini 4 Argon | 3 mức: thấp, vừa, cao |
Suy nghĩ thích ứng nghĩa là mô hình tự quyết định nghĩ bao nhiêu. Việc ngắn như hỏi một định nghĩa hay dịch một câu có thể chỉ cần mức thấp. Bài toán nhiều bước, đoạn mã dài hay tài liệu cần so kỹ mới đáng tốn thêm token. Anthropic xếp tốc độ các mô hình của mình như sau: Claude Fable 5.1 chậm hơn, Opus 5.5 vừa, Sonnet 5.5 nhanh, Haiku 5.5 nhanh nhất. Suy luận kỹ hơn không thay được việc bạn kiểm tra lại câu trả lời quan trọng.
Mô hình ngôn ngữ lớn được ứng dụng vào 6 nhóm việc nào?
Mô hình ngôn ngữ lớn được dùng chủ yếu cho 6 nhóm việc. Đó là viết và biên tập, tóm tắt và tra cứu tài liệu, dịch thuật, lập trình, chăm sóc khách hàng, phân tích dữ liệu và hỗ trợ học tập. Ở nhóm nào, kết quả quan trọng cũng cần người kiểm tra lại trước khi dùng.
Theo AI Index 2025 của Stanford HAI, 78% tổ chức cho biết có dùng AI trong năm 2024. Năm trước đó, tỷ lệ này là 55%.
Tỷ lệ tổ chức có dùng AI
Xem số liệu
| Đơn vị: % | Giá trị |
|---|---|
| 2023 | 55 |
| 2024 | 78 |
- Viết và biên tập nội dung: sinh viên nhờ mô hình góp ý bố cục bài luận, nhân viên văn phòng soạn nháp email hay báo cáo. Người viết cần tự kiểm số liệu, tên riêng và giọng văn của bản cuối.
- Tóm tắt và tra cứu tài liệu: nhân viên đưa hợp đồng hay biên bản dài vào để lấy ý chính. Điều khoản quan trọng vẫn cần được đọc lại ở bản gốc.
- Dịch thuật: chủ cửa hàng nhỏ dịch mô tả sản phẩm sang tiếng Anh. Văn bản pháp lý hay hợp đồng vẫn cần người thạo cả hai thứ tiếng duyệt lại.
- Lập trình: dân IT nhờ mô hình viết hàm, giải thích lỗi, viết mã kiểm thử. Mã sinh ra phải được chạy thử và rà soát bảo mật trước khi đưa vào sản phẩm.
- Chăm sóc khách hàng: mô hình trả lời câu hỏi thường gặp, phân loại yêu cầu và chuyển tới đúng bộ phận. Quyết định về đổi trả, hoàn tiền nên do người phụ trách đưa ra.
- Phân tích dữ liệu và hỗ trợ học tập: mô hình đọc bảng số để nêu xu hướng, hoặc giải thích lại một khái niệm theo nhiều cách cho người học. Phép tính quan trọng cần được kiểm bằng công cụ tính toán.
Theo OpenAI, khi gọi qua API, các mô hình GPT-6 còn dùng được công cụ: gọi hàm, tìm kiếm web, tìm trong tệp và điều khiển máy tính (computer use). Khi mô hình tự làm cả chuỗi thao tác như vậy để xong việc, nó trở thành tác tử AI agent.
Mô hình ngôn ngữ lớn khác công cụ tìm kiếm thế nào?
Công cụ tìm kiếm trả về danh sách trang web có sẵn, còn mô hình ngôn ngữ lớn tự viết ra câu trả lời mới từ những gì nó đã học. Câu trả lời của LLM tiện hơn nhưng có thể sai mà không kèm nguồn. Kiến thức của nó cũng dừng ở thời điểm dữ liệu cuối của lần huấn luyện.
| Tiêu chí | Công cụ tìm kiếm | Mô hình ngôn ngữ lớn |
|---|---|---|
| Cách tạo kết quả | Liệt kê các trang web có sẵn liên quan tới câu hỏi | Viết câu trả lời mới bằng cách đoán lần lượt từng token |
| Độ mới của thông tin | Theo các trang đã được thu thập và cập nhật | Dừng ở mốc dữ liệu cuối, trừ khi có tìm kiếm web hoặc tài liệu đưa vào |
| Dẫn nguồn | Mỗi kết quả là một đường dẫn tới trang nguồn | Không kèm nguồn nếu không dùng công cụ tìm kiếm hay truy xuất |
| Rủi ro sai | Trang có thể sai, nhưng người đọc thấy rõ trang nào nói | Có thể viết điều sai nhưng trông hợp lý |
| Loại câu hỏi phù hợp | Tin mới, giá mới, lịch, văn bản gốc | Giải thích khái niệm, tóm tắt, viết nháp, sắp xếp ý |
Hai cách đang được ghép lại. Theo IBM, kỹ thuật tạo sinh có tăng cường truy xuất (retrieval augmented generation, RAG) đưa thông tin bên ngoài vào cửa sổ ngữ cảnh của mô hình, không cần huấn luyện lại. Các mô hình GPT-6 có công cụ tìm kiếm web. Google thì đưa câu trả lời tổng hợp lên ngay trang kết quả.
Với câu hỏi cần dữ kiện mới hoặc văn bản gốc như luật, giá, lịch, bạn nên mở trang nguồn. Với câu hỏi cần giải thích hay sắp xếp ý, hỏi mô hình thường nhanh hơn.
Mô hình ngôn ngữ lớn đang thay đổi cách tìm thông tin ra sao?
Người dùng đang chuyển từ việc tự mở nhiều trang web sang đọc một câu trả lời tổng hợp sẵn, kể cả ngay trên trang kết quả của Google. Ba thay đổi đang diễn ra:
- Câu trả lời tổng hợp trên trang tìm kiếm: Google công bố AI Overviews ngày 14/05/2024 và đưa tới mọi người dùng tại Mỹ ngay tuần đó, các nước khác theo sau. Hãng dự kiến phục vụ hơn 1 tỷ người vào cuối năm 2024. Theo Elizabeth Reid, Phó chủ tịch phụ trách Search, người dùng đã dùng tính năng này hàng tỷ lần trong giai đoạn thử nghiệm Search Labs.
- Chế độ hỏi đáp riêng: ngày 07/10/2025, Google mở rộng AI Mode thêm hơn 35 ngôn ngữ và hơn 40 quốc gia, vùng lãnh thổ. Tổng cộng, AI Mode có mặt ở hơn 200 quốc gia và vùng lãnh thổ. Người công bố là Hema Budaraju, Phó chủ tịch quản lý sản phẩm Search.
- Chatbot tự tìm web: mô hình tra trang mới rồi viết câu trả lời. Nhờ đó nó vượt qua thời điểm dữ liệu cuối và có thể kèm đường dẫn để người đọc kiểm.
Để không bị câu trả lời tổng hợp đánh lừa, bạn nên bấm vào nguồn gốc của câu trả lời và xem ngày đăng của trang đó trước khi dùng.
Cách một mô hình ngôn ngữ lớn được huấn luyện
Mô hình được huấn luyện qua nhiều giai đoạn: thu thập và làm sạch dữ liệu, tiền huấn luyện trên cụm GPU, tinh chỉnh, rồi học từ phản hồi của con người. Quá trình ấy để lại hai hệ quả cho người dùng. Kiến thức của mô hình dừng ở một thời điểm, và dữ liệu huấn luyện đang vướng tranh chấp bản quyền.
Dữ liệu huấn luyện của mô hình đến từ đâu?
Dữ liệu huấn luyện đến từ khối văn bản rất lớn chưa gán nhãn, từ sách, và từ dữ liệu do con người soạn hoặc chấm riêng cho việc huấn luyện. Có khi nó đến từ chính cuộc trò chuyện của người dùng, nếu họ đồng ý.
- Văn bản chưa gán nhãn: theo IBM, tiền huấn luyện dùng học tự giám sát trên văn bản thường lên tới hàng tỷ hoặc hàng nghìn tỷ từ.
- Sách: trong vụ Bartz kiện Anthropic, bên kiện cáo buộc hãng tải sách từ các kho lậu LibGen và PiLiMi để huấn luyện mô hình.
- Dữ liệu do người viết và chấm: nhóm tác giả InstructGPT dùng câu trả lời mẫu do người gán nhãn viết. Sau đó họ dùng thứ hạng mà người chấm xếp cho các câu trả lời.
- Cuộc trò chuyện của người dùng: Anthropic và Google đều có tùy chọn dùng cuộc trò chuyện để huấn luyện, và người dùng tự bật hoặc tắt được.
Theo IBM, dữ liệu được làm sạch và bỏ phần trùng lặp trước khi huấn luyện. Lượng dữ liệu cũng tăng rất nhanh. Theo AI Index 2025, dữ liệu huấn luyện tăng gấp đôi khoảng mỗi 8 tháng.
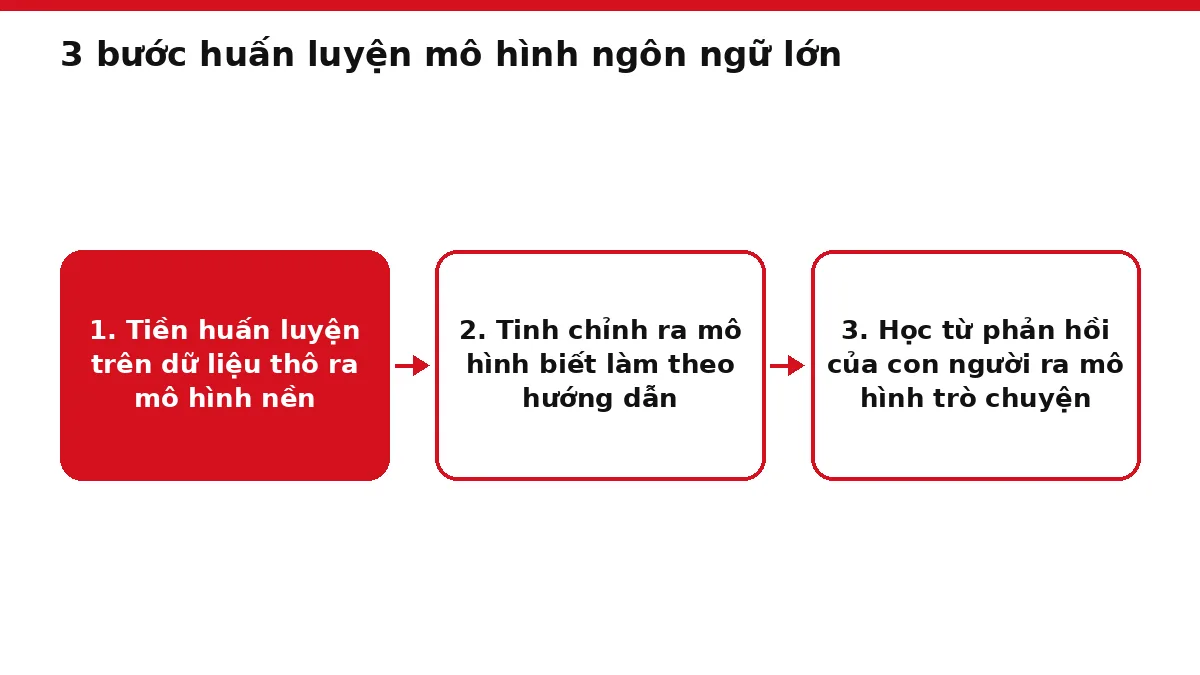
3 bước huấn luyện: tiền huấn luyện, tinh chỉnh và học từ phản hồi của con người
Huấn luyện một mô hình ngôn ngữ lớn gồm 3 bước. Tiền huấn luyện giúp mô hình học ngôn ngữ từ dữ liệu khổng lồ. Tinh chỉnh (fine-tuning) dạy nó làm theo hướng dẫn. Cuối cùng, học tăng cường từ phản hồi của con người (RLHF) giúp câu trả lời hữu ích và phù hợp hơn.
- Tiền huấn luyện: mô hình tự tập đoán token tiếp theo trên văn bản chưa gán nhãn. Theo IBM, sau mỗi lần đoán, một công thức gọi là hàm mất mát đo xem mô hình sai bao nhiêu. Các kỹ thuật lan truyền ngược và hạ gradient rồi chỉnh lại trọng số cho bớt sai. Kết quả là mô hình nền: biết nhiều về ngôn ngữ nhưng chưa được dạy để trò chuyện theo yêu cầu.
- Tinh chỉnh: theo IBM, tinh chỉnh có giám sát (supervised fine-tuning) dùng một bộ dữ liệu nhỏ hơn, có gán nhãn. Cách này chỉnh mô hình chung cho việc riêng, như tóm tắt hay một lĩnh vực chuyên môn. Tinh chỉnh theo chỉ dẫn (instruction tuning) giúp mô hình làm theo yêu cầu tốt hơn. Doanh nghiệp cũng có thể tinh chỉnh mô hình cho việc của mình theo cách này.
- Học từ phản hồi của con người (RLHF): người chấm xếp hạng các câu trả lời, và mô hình học cách ưu tiên câu được xếp hạng cao. Theo IBM, bước này thường dùng để căn chỉnh mô hình (alignment), tức đưa hành vi của mô hình về đúng ý người dùng, và để chỉnh văn phong. Bài báo InstructGPT, nộp lên arXiv tháng 3/2022, có 20 tác giả. Nhóm này tinh chỉnh GPT-3 bằng câu trả lời mẫu, rồi dùng RLHF dựa trên thứ hạng các câu trả lời.
Cũng có cách không cần người chấm từng câu. Bài báo Constitutional AI của Anthropic, nộp lên arXiv tháng 12/2022, dạy mô hình tránh gây hại bằng một danh sách nguyên tắc viết sẵn. Mô hình tự phê bình và sửa câu trả lời của mình. Sau đó một mô hình AI chọn câu tốt hơn trong hai câu. Cách này gọi là RLAIF, tức học tăng cường từ phản hồi của AI.
Anthropic giới thiệu bộ nguyên tắc này ngày 09/05/2023. Nguồn của nó gồm Tuyên ngôn Quốc tế Nhân quyền của Liên Hợp Quốc, các thực hành an toàn và tin cậy, và nguyên tắc Sparrow của DeepMind. Ngày 21/01/2026, hãng công bố phiên bản mới dành cho Claude.
GPU đóng vai trò gì trong huấn luyện mô hình?
GPU là bộ xử lý làm song song rất nhiều phép tính cùng lúc, nên nó là phần cứng chính để huấn luyện và chạy mô hình ngôn ngữ lớn. Theo NVIDIA, GPU hợp với việc huấn luyện LLM vì giải được các bài toán của mô hình song song với nhau.
Ngoài GPU còn có chip chuyên dụng. Theo Google Cloud, TPU (Tensor Processing Unit) là mạch tích hợp chuyên dụng (ASIC) do Google tự phát triển. Nó tăng tốc học máy bằng các phép toán ma trận lớn, tức phép tính trên những bảng số khổng lồ. Hãng xếp CPU hợp với thử nghiệm nhanh và mô hình đơn giản, GPU hợp với mô hình vừa và lớn. TPU hợp với việc chủ yếu là tính ma trận, như mô hình cần huấn luyện hàng tuần hoặc hàng tháng.
Một lần huấn luyện cần cả cụm chip ghép lại trong trung tâm dữ liệu. Năm 2017, transformer đầu tiên chỉ chạy trên 8 GPU. Theo NVIDIA, huấn luyện một LLM ngày nay "cần hàng nghìn GPU và hàng tuần tới hàng tháng". Lượng điện cho huấn luyện cũng tăng gấp đôi mỗi năm, theo AI Index 2025. Chuyện này dẫn tới câu hỏi về điện năng mà trung tâm dữ liệu AI tiêu thụ.
Giới hạn kiến thức theo thời điểm của mô hình là gì?
Giới hạn kiến thức theo thời điểm (knowledge cutoff) là thời điểm cuối của dữ liệu huấn luyện. Mô hình không tự biết những gì xảy ra sau thời điểm đó. Mỗi mô hình chỉ học từ dữ liệu thu thập tới một ngày nhất định, và hãng công bố ngày ấy. Với các mô hình mới nhất của OpenAI và Anthropic, ngày giới hạn rơi vào khoảng cuối tháng 4 tới tháng 6/2026.
| Mô hình | Ngày giới hạn kiến thức | Nguồn (cập nhật ngày 19/10/2026) |
|---|---|---|
| gpt-6-astra, gpt-6.1-sol | 30/04/2026 | OpenAI |
| gpt-6-luna | 18/05/2026 | OpenAI |
| Claude Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5 | Tháng 6/2026 | Anthropic |
Anthropic tách hai thời điểm. Một là lúc kiến thức của mô hình đầy đủ và tin cậy nhất, hai là ngày cuối của dữ liệu huấn luyện. Với bốn mô hình Claude trên, cả hai đều là tháng 6/2026.
Tính tới ngày 19/10/2026, kiến thức của gpt-6-astra đã cũ gần 6 tháng, của các mô hình Claude 5.5 hơn 3 tháng. Vì vậy hỏi về tin mới, giá mới có thể nhận câu trả lời cũ.
Chatbot bù lại bằng hai cách: tìm kiếm web để lấy trang mới, hoặc nhận tài liệu bạn tải lên để đưa thẳng vào cửa sổ ngữ cảnh. Muốn biết ngày giới hạn của mô hình đang dùng, bạn xem trang mô hình chính thức của hãng thay vì hỏi chính chatbot.
Tranh chấp bản quyền dữ liệu huấn luyện đang diễn ra thế nào?
Tranh chấp bản quyền dữ liệu huấn luyện xoay quanh một câu hỏi. Hãng AI có được dùng tác phẩm có bản quyền để huấn luyện mô hình mà không xin phép hay không? Nhiều vụ đã ra tòa ở Mỹ và Anh. Ở Mỹ, câu hỏi chính là việc huấn luyện có được tính là sử dụng hợp lý (fair use) hay không. Đây là ngoại lệ cho phép dùng tác phẩm mà không cần xin phép.
Trong các vụ đã ra tòa, vụ các tác giả kiện Anthropic đã đi tới thỏa thuận dàn xếp 1,5 tỷ USD.
| Vụ việc | Tòa, nước | Thời điểm | Diễn biến | Ngày tra cứu |
|---|---|---|---|---|
| The New York Times kiện OpenAI và Microsoft | Tòa Liên bang quận Nam New York, Mỹ | 27/12/2023: nộp đơn | Đơn 69 trang cáo buộc hàng triệu bài báo bị dùng để huấn luyện chatbot mà không xin phép. Tờ báo đòi bồi thường và yêu cầu hủy các mô hình, bộ dữ liệu có chứa tác phẩm của mình | 19/10/2026 |
| Kadrey và các tác giả, gồm Sarah Silverman, Ta-Nehisi Coates, kiện Meta Platforms | Tòa Liên bang quận Bắc California, Mỹ | 25/06/2025: phán quyết một phần | Thẩm phán Vince Chhabria coi việc dùng sách để huấn luyện Llama là sử dụng hợp lý dựa trên hồ sơ của vụ này. Kết quả có thể khác nếu bên nguyên có hồ sơ tốt hơn về thiệt hại thị trường | 19/10/2026 |
| Getty Images kiện Stability AI | Tòa Tối cao Anh (High Court) | 04/11/2025: phán quyết | Getty rút khiếu nại về huấn luyện trước phiên xử vì việc huấn luyện không gắn với Vương quốc Anh. Tòa bác khiếu nại vi phạm bản quyền thứ cấp, chỉ xác định vi phạm nhãn hiệu ở mức rất hạn chế liên quan hình mờ | 19/10/2026 |
| Bartz và cộng sự kiện Anthropic PBC | Tòa Liên bang quận Bắc California, Mỹ | 20/07/2026: phê chuẩn lần cuối thỏa thuận dàn xếp | Dàn xếp 1,5 tỷ USD cộng lãi cho danh sách 482.460 tác phẩm, ước khoảng 3.000 USD mỗi tác phẩm. Đợt chi trả đầu dự kiến vào hoặc trước 15/11/2026 | 19/10/2026 |
Hồ sơ hai vụ ở California được lưu trên GovInfo: hồ sơ Kadrey v. Meta số 3:23-cv-03417 và hồ sơ Bartz v. Anthropic số 3:24-cv-05417. Vụ ở Anh có phán quyết [2025] EWHC 2863 (Ch) của thẩm phán Joanna Smith DBE. Theo phán quyết, trọng số của Stable Diffusion không lưu bản sao ảnh của Getty.
Thỏa thuận dàn xếp vụ Bartz chỉ giải quyết một phần tranh chấp. Theo trang dàn xếp của vụ và trang tin pháp lý Jurist, thẩm phán Araceli Martínez-Olguín bác 53 ý kiến phản đối. Tòa cho luật sư bên nguyên hưởng khoảng 101,6 triệu USD, tức khoảng 6,8% quỹ. Mức được đề nghị ban đầu là 12,5%. Thỏa thuận chỉ miễn trách nhiệm cho hành vi tới ngày 25/08/2025 và không tính các khiếu nại về đầu ra của AI. Anthropic cũng phải hủy các tệp đã tải từ LibGen và PiLiMi.
Các vụ này chưa cho ra một kết luận chung. Phán quyết vụ Meta chỉ dựa trên hồ sơ của riêng vụ đó. Phán quyết ở Anh không xét việc huấn luyện. Vì vậy chưa vụ nào là câu trả lời cho mọi trường hợp.
Cửa sổ ngữ cảnh của mô hình ngôn ngữ lớn là gì?
Cửa sổ ngữ cảnh là lượng token tối đa mà mô hình đọc và giữ được trong một lần làm việc. Nó gồm câu hỏi, tài liệu đính kèm, lịch sử trò chuyện và cả câu trả lời của mô hình. Các mô hình hiện hành của OpenAI, Anthropic và Google đều có cửa sổ khoảng 1 triệu token.
Theo tài liệu về cửa sổ ngữ cảnh của Anthropic, đây là bộ nhớ làm việc của mô hình, khác với kho dữ liệu đã dùng để huấn luyện. Lời nhắc hệ thống (system prompt) cũng tính vào cửa sổ. Đó là phần chỉ dẫn mà ứng dụng gửi kèm trước câu hỏi của bạn. Các tin nhắn kèm kết quả công cụ, ảnh, tài liệu, cùng định nghĩa công cụ và câu trả lời cũng vậy.
Ba hãng gần như ngang nhau về độ rộng cửa sổ, nhưng khác nhau ở giới hạn đầu ra.
| Hãng | Mô hình | Cửa sổ ngữ cảnh (token) | Đầu ra tối đa (token) |
|---|---|---|---|
| OpenAI | gpt-6-astra, gpt-6.1-sol, gpt-6-luna | 1.050.000 | 128.000 |
| Anthropic | Claude Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5 | 1.000.000 | 128.000 |
| Gemini 4 Argon | 1.048.576, dùng chung cho đầu vào, suy nghĩ và đầu ra | 65.536 mặc định, tới 1.048.576 với chế độ giải mã dài (long decode) |
Nguồn: công bố của OpenAI, Anthropic và Google.
Các mô hình Claude cũ như Sonnet 4.5 có cửa sổ 200.000 token. Llama 4 Scout của Meta được công bố với cửa sổ 10 triệu token.
Theo Anthropic, với bộ tách token hiện tại của Claude, 1 triệu token vào khoảng 555.000 từ. Với Gemini, mỗi token dài khoảng 4 ký tự, nên cửa sổ của Gemini 4 Argon chứa khoảng 4,2 triệu ký tự. Với văn bản tiếng Việt, số token có thể khác.
Văn bản dài có khiến mô hình quên phần đầu không?
Có. Khi văn bản vượt cửa sổ ngữ cảnh, phần cũ bị đẩy ra hoặc yêu cầu bị từ chối. Kể cả khi còn trong cửa sổ, mô hình có thể bỏ sót thông tin nằm giữa văn bản dài.
Theo Anthropic, giao diện chat như claude.ai có thể xử lý theo kiểu vào trước, ra trước, tức phần cũ nhất bị bỏ trước. Qua API, đầu vào vượt cửa sổ bị trả lỗi 400 kèm thông điệp prompt is too long. Tính năng nén (compaction) tự tóm tắt phần đầu cuộc trò chuyện để nói tiếp quá giới hạn. Hãng gọi một hiện tượng khác là context rot: số token càng tăng, độ chính xác và khả năng nhớ lại càng giảm. Vì vậy nhiều ngữ cảnh hơn không tự động tốt hơn.
Một nghiên cứu khác mô tả hiện tượng lạc ở giữa (lost in the middle). Bài báo "Lost in the Middle: How Language Models Use Long Contexts" của Nelson F. Liu và 6 đồng tác giả được nộp lên arXiv tháng 7/2023. Sau đó bài được đăng ở tạp chí TACL. Nhóm thử trên hai bài: hỏi đáp nhiều tài liệu và truy xuất khóa–giá trị. Mô hình làm tốt nhất khi thông tin cần dùng nằm ở đầu hoặc cuối văn bản, và kém đi rõ khi thông tin nằm ở giữa. Điều này đúng cả với mô hình thiết kế cho ngữ cảnh dài. Mô hình mới hơn có thể đã cải thiện ở các mức khác nhau. Có ba cách giảm rủi ro:
- Chia tài liệu dài thành nhiều phần và hỏi lần lượt từng phần.
- Đặt ý quan trọng ở đầu hoặc cuối câu hỏi, hoặc nhắc lại ý đó.
- Mở cuộc trò chuyện mới khi chủ đề đã đổi.
Khi nào cần mô hình có cửa sổ ngữ cảnh lớn?
Cửa sổ ngữ cảnh lớn chỉ cần thiết khi phải đưa cho mô hình một lượng tài liệu dài trong cùng một lần. Với câu hỏi ngắn hằng ngày, nó gần như không tạo ra khác biệt.
- Đọc hợp đồng, báo cáo năm hay hồ sơ dài hàng trăm trang.
- Phân tích cả một kho mã nguồn của dân IT.
- Tổng hợp nhiều tài liệu cùng lúc, như một bộ ảnh chụp hoặc trang PDF. Theo Anthropic, một yêu cầu gửi Claude kèm được tối đa 600 ảnh hoặc trang PDF. Với mô hình có cửa sổ 200.000 token, mức này là 100.
Cái giá phải trả là tiền và độ chính xác. Mọi token đưa vào đều tính tiền. Một số mô hình còn tăng giá khi lời nhắc dài, như Claude Haiku 5.5 khi vượt 100.000 token hay Gemini 2.5 Pro khi vượt 200.000 token.
Chi phí vận hành một mô hình ngôn ngữ lớn
Chi phí vận hành một mô hình gồm hai phần. Chi phí huấn luyện chỉ trả một lần và do hãng gánh. Chi phí sử dụng tính theo token, do người dùng hoặc doanh nghiệp trả mỗi lần gọi mô hình.
Chi phí huấn luyện một mô hình lớn ở mức nào?
Chi phí huấn luyện một mô hình lớn hàng đầu được ước tính từ hàng chục tới hàng trăm triệu USD. Các con số hay được dẫn nhất là ước tính của bên ngoài và chỉ tính phần điện toán. Gemini Ultra của Google được ước tính tốn gần gấp 2,5 lần GPT-4.
| Mô hình | Chi phí ước tính (USD) | Quy đổi VND | Nguồn và năm |
|---|---|---|---|
| GPT-4 (OpenAI) | Khoảng 78 triệu, chỉ tính điện toán | Khoảng 2.034 tỷ đồng | Stanford HAI, AI Index 2024 |
| Gemini Ultra (Google) | Khoảng 191 triệu, chỉ tính điện toán | Khoảng 4.981 tỷ đồng | Stanford HAI, AI Index 2024 |
| GPT-3 (OpenAI) | Có thể hơn 12 triệu cho một lần huấn luyện, chỉ tính điện toán | Từ khoảng 313 tỷ đồng | NVIDIA, theo một số ước tính |
AI Index 2024 chỉ tính tiền điện toán, tức tiền chạy chip trong lần huấn luyện. Các khoản khác của cả dự án chưa nằm trong đó. Chi phí tăng qua từng thế hệ vì quy mô tăng. Theo AI Index 2025, sức tính toán dùng để huấn luyện tăng gấp đôi khoảng mỗi 5 tháng. Theo AI Index 2026, khối doanh nghiệp làm ra hơn 90% số mô hình tiên phong đáng chú ý năm 2025.
Phí dùng mô hình được tính theo token như thế nào?
Phí dùng mô hình qua API tính theo số token, thường báo giá cho mỗi 1 triệu token. Token đầu vào, tức câu hỏi và tài liệu gửi đi, có giá khác token đầu ra, tức câu trả lời. Với các mô hình chủ lực của OpenAI, Anthropic và Google, giá đầu ra gấp 4 tới 5 lần giá đầu vào.
Hóa đơn tính riêng cho phần gửi đi và phần nhận về, mỗi phần theo số token và đơn giá của nó. Ví dụ: một phút ghi âm vào khoảng 1.920 token, theo Google. Gửi đoạn này cho Gemini 4 Argon tốn chưa tới 0,004 USD, khoảng 100 đồng. Giá đầu vào của mô hình này là 2 USD mỗi triệu token. Ở đầu kia, gửi đầy cửa sổ của Gemini 4 Argon tốn khoảng 2,10 USD, tức khoảng 54.700 đồng, mới chỉ tính phần đầu vào.
Bốn yếu tố làm hóa đơn thay đổi đáng kể:
- Token suy luận: Anthropic tính token suy nghĩ như token đầu ra, còn Google ghi giá đầu ra của Gemini đã gồm token suy nghĩ.
- Lịch sử trò chuyện: mọi tin nhắn trước đó nằm trong cửa sổ ngữ cảnh của mỗi lượt, nên cuộc trò chuyện càng dài thì mỗi lượt có thể càng tốn.
- Xử lý theo lô (batch): gửi yêu cầu để xử lý sau thay vì chờ trả lời ngay, rẻ hơn 50% ở cả OpenAI, Anthropic và Google.
- Bộ nhớ đệm câu lệnh (prompt caching): phần lời nhắc lặp lại được đọc lại với giá thấp. Ở Anthropic, đọc bộ đệm tốn 10% giá đầu vào gốc. Riêng Claude Fable 5.1 chỉ tốn 2,5%, Opus 5.5 và Sonnet 5.5 tốn 5%.
Gói chat trả phí theo tháng là một cách trả khác, cố định thay vì theo token. Theo bảng giá Claude, gói Free miễn phí. Gói Pro giá 20 USD/tháng, khoảng 521.600 đồng, nếu trả theo tháng. Trả theo năm thì Pro còn 17 USD/tháng, trả trước 200 USD. Gói Max giá từ 100 USD/tháng, khoảng 2,6 triệu đồng.
Về lâu dài, giá dùng mô hình giảm rất nhanh. Theo AI Index 2025, chi phí chạy một hệ thống ở mức GPT-3.5 giảm hơn 280 lần từ tháng 11/2022 tới tháng 10/2024.
Giá API của các nhà cung cấp mô hình lớn so với nhau ra sao?
Giá API chênh nhau nhiều lần tùy hạng mô hình. Trong cùng một hãng, mô hình nhỏ rẻ hơn rõ rệt so với mô hình mạnh nhất. Ở cả OpenAI lẫn Anthropic, mô hình đắt nhất có giá gấp 100 lần mô hình rẻ nhất.
| Nhà cung cấp | Mô hình | Giá đầu vào (USD/1 triệu token) | Giá đầu ra (USD/1 triệu token) | Quy đổi VND đầu ra | Cửa sổ ngữ cảnh (token) |
|---|---|---|---|---|---|
| OpenAI | gpt-6-astra | 10 | 50 | 1.304.000 | 1.050.000 |
| OpenAI | gpt-6.1-sol | 2 | 10 | 260.800 | 1.050.000 |
| OpenAI | gpt-6-luna | 0,10 | 0,50 | 13.040 | 1.050.000 |
| Anthropic | Claude Fable 5.1 | 10 | 50 | 1.304.000 | 1.000.000 |
| Anthropic | Claude Opus 5.5 | 4 | 20 | 521.600 | 1.000.000 |
| Anthropic | Claude Sonnet 5.5 | 2 | 10 | 260.800 | 1.000.000 |
| Anthropic | Claude Haiku 5.5 (lời nhắc tới 100.000 token) | 0,10 | 0,50 | 13.040 | 1.000.000 |
| Gemini 4 Argon | 2 | 10 | 260.800 | 1.048.576 | |
| Gemini 2.5 Flash-Lite | 0,10 | 0,40 | 10.432 | 1.048.576 (đầu vào) |
Nguồn: bảng giá API của OpenAI, bảng giá Claude và bảng giá Gemini API, theo công bố của hãng.
Mỗi hãng chia mô hình thành nhiều hạng. Theo OpenAI, gpt-6-astra mạnh nhất, dành cho việc khó nhất. Mô hình gpt-6.1-sol gần bằng Astra nhưng rẻ hơn, còn gpt-6-luna tiết kiệm nhất.
Giá còn đổi theo thời điểm và theo độ dài lời nhắc. Khi lời nhắc vượt 100.000 token, Claude Haiku 5.5 tăng giá gấp 5 lần. Khi đó đầu vào là 0,50 USD, đầu ra là 2,50 USD. Ở OpenAI, mô hình GPT-5.6 Sol, không có trong bảng trên, đang có giá khuyến mãi ít nhất tới ngày 21/11/2026. OpenAI cũng cộng 10% cho điểm xử lý theo vùng, tức lưu dữ liệu tại một vùng địa lý, với các mô hình phát hành từ ngày 05/03/2026.
Chỉ so giá thì chưa đủ. Chất lượng câu trả lời, tốc độ và cửa sổ ngữ cảnh cũng khác nhau giữa các mô hình. Giá lại đổi thường xuyên, nên bạn cần kiểm lại trên trang giá của hãng trước khi dùng.
Giới hạn tốc độ và hạn mức của các gói API
Giới hạn tốc độ (rate limit) là số yêu cầu hoặc số token tối đa mà một tài khoản API được gửi trong mỗi phút hay mỗi ngày. Mức này tăng dần theo bậc tài khoản, xét theo số tiền đã nạp hoặc đã chi. Có ba loại giới hạn chính:
- Số yêu cầu: OpenAI, Anthropic và Google đều đo số yêu cầu mỗi phút (RPM). OpenAI và Google đo thêm số yêu cầu mỗi ngày (RPD).
- Số token: OpenAI đo token mỗi phút (TPM) và mỗi ngày (TPD). Anthropic tách token đầu vào (ITPM) với token đầu ra (OTPM). Google đo token đầu vào mỗi phút.
- Hạn mức chi tiêu: Anthropic đặt trần mỗi tháng là 500 USD ở bậc Start và 1.000 USD ở bậc Build. Bậc Scale được chi tới 200.000 USD. OpenAI đặt hạn mức dùng mỗi tháng từ 100 USD ở bậc Free tới 200.000 USD ở bậc Grow.
Bậc tài khoản lên theo tiền. Ở OpenAI, tài khoản tự lên bậc Build khi đã nạp tổng 5 USD. Mức nạp để lên Launch là 100 USD, lên Grow là 500 USD. Với các mô hình Astra, Sol, Terra, bậc Build được gửi 5.000 yêu cầu và 1 triệu token mỗi phút. Ở bậc Grow, mức này lên 15.000 yêu cầu và 40 triệu token.
Google tính giới hạn theo dự án chứ không theo khóa API. Tài khoản lên Tier 2 khi đã chi tổng 100 USD và qua 3 ngày từ lần trả tiền đầu. Lên Tier 3 cần chi 1.000 USD và qua 30 ngày. Anthropic dùng thuật toán thùng token (token bucket): sức chứa được nạp lại liên tục, không đặt lại vào một giờ cố định.
Vượt giới hạn thì yêu cầu bị từ chối. OpenAI trả lỗi HTTP 429, có thể kèm thời gian chờ (Retry-After). Yêu cầu bị lỗi vẫn tính vào giới hạn mỗi phút. Ở Anthropic, tài khoản chạm hạn mức chi tiêu sẽ nhận lỗi HTTP 429. API tạm dừng tới 0 giờ UTC ngày đầu tháng sau.
Tự triển khai mô hình mở hay thuê API: cách nào tốn ít hơn?
Thuê API thường tốn ít hơn khi lượng dùng còn nhỏ và không đều. Tự triển khai mô hình mở chỉ có thể rẻ hơn khi lượng dùng lớn, ổn định và có đội ngũ vận hành. Với mô hình nguồn mở như Llama 4 của Meta, bạn tải trọng số qua llama.com hoặc Hugging Face rồi tự chạy. Ba cách khác nhau chủ yếu ở chi phí ban đầu và người phải vận hành.
| Phương án | Chi phí ban đầu | Chi phí theo lượng dùng | Phù hợp khi |
|---|---|---|---|
| Gọi API của hãng | Không mua phần cứng. Ở OpenAI, nạp tổng 5 USD để lên bậc Build | Trả theo token, rẻ hơn 50% khi xử lý theo lô | Lượng dùng nhỏ, không đều, cần bắt đầu nhanh |
| Thuê máy chủ GPU trên đám mây để chạy mô hình mở | Không mua máy, nhưng cần người cài đặt và vận hành | Trả theo giờ thuê, ví dụ 47,757 USD/giờ cho một máy p5.48xlarge 8 GPU H100 trên AWS, phí hệ điều hành tính riêng | Lượng dùng lớn, ổn định, cần giữ dữ liệu trong hạ tầng mình thuê |
| Chạy trên máy của mình | Tiền mua máy | Điện và bảo trì | Thử nghiệm nhỏ, dữ liệu không được rời khỏi máy |
Theo bảng giá EC2 Capacity Blocks của AWS, giá thuê mỗi GPU theo giờ chênh hơn 8 lần giữa thế hệ A100 và B200.
Giá thuê mỗi GPU theo giờ trên AWS Capacity Blocks
Xem số liệu
| Đơn vị: USD mỗi GPU mỗi giờ | Giá trị |
|---|---|
| B200 | 14,21 |
| H200 | 6,87 |
| H100 | 5,97 |
| A100 | 1,7 |
Tự thuê GPU có thể có lợi khi máy chạy gần hết công suất. Thuê một máy p5.48xlarge trọn một ngày tốn khoảng 1.146 USD, gần 29,9 triệu đồng. Số tiền đó mua được khoảng 114,6 triệu token đầu ra của Claude Sonnet 5.5 hay gpt-6.1-sol. Hai mô hình này có giá đầu ra 10 USD mỗi triệu token. Ngoài tiền máy còn có nhân lực và bảo trì. Bù lại, dữ liệu nằm trong hạ tầng của bạn. AWS dự kiến cập nhật giá vào tháng 1/2027.
Cách ước tính chi phí mô hình ngôn ngữ lớn cho một sản phẩm phần mềm
Ước tính chi phí mô hình ngôn ngữ lớn cho một sản phẩm phần mềm gồm 4 bước. Đó là đo số token trung bình mỗi lượt, ước lượng số lượt mỗi tháng, nhân với đơn giá, rồi cộng thêm phần dự phòng.
- Đo token mỗi lượt: chạy thử các tình huống thật của sản phẩm và ghi riêng số token đầu vào, đầu ra, kể cả token suy luận.
- Ước lượng số lượt: nhân số người dùng dự kiến với số lượt mỗi người trong một tháng.
- Nhân với đơn giá: lấy số token mỗi lượt nhân số lượt và đơn giá mỗi triệu token, tính riêng đầu vào và đầu ra. Sau đó đổi ra đồng theo một tỷ giá có ghi ngày.
- Cộng dự phòng cho các khoản hay bị quên: token suy luận, lượt gọi lại khi lỗi, phí ghi bộ đệm. Ở Anthropic, ghi bộ đệm 5 phút của Claude Sonnet 5.5 giá 2,50 USD mỗi triệu token. Mức này cao hơn giá đầu vào thường, 2 USD.
Với kế hoạch thử ba tháng, lịch tăng giá là khoản dễ bị bỏ sót. Nếu bắt đầu thử từ cuối tháng 10/2026, tháng thứ hai đã sang ngày 01/12/2026. Từ ngày đó, giá Gemini 4 Argon tăng gấp đôi, lên 4 USD đầu vào và 20 USD đầu ra. Giá lưu đệm ngữ cảnh của mô hình này cũng lên từ 0,10 USD thành 0,20 USD. Từ ngày 01/01/2027, Gemini 3.8 Flash cũng tăng gấp đôi. Giá đầu vào lên từ 0,75 USD thành 1,50 USD. Giá đầu ra lên từ 3,75 USD thành 7,50 USD. Cách làm an toàn là tính từng tháng theo đơn giá của tháng đó. Khi lượng người dùng thật khác dự kiến, bạn tính lại.
Mô hình ngôn ngữ lớn nguồn mở là gì?
Mô hình nguồn mở là mô hình được công bố trọng số để ai cũng tải về, chạy và tinh chỉnh. Ví dụ là Llama 4 Scout và Llama 4 Maverick, Meta phát hành ngày 05/04/2025. Gọi chính xác thì đây là mô hình mở trọng số (open-weight), vì nguồn mở đầy đủ đòi hỏi nhiều hơn.
Theo Định nghĩa AI nguồn mở 1.0 của Open Source Initiative, nguồn mở đầy đủ không dừng ở trọng số. Bên phát hành còn phải công bố thông tin về dữ liệu huấn luyện và toàn bộ mã nguồn để huấn luyện, chạy mô hình. Khác biệt giữa hai khái niệm và cách dùng loại mô hình này nằm ở bài mô hình ngôn ngữ lớn nguồn mở.
Mô hình ngôn ngữ lớn bị giới hạn ở những điểm nào?
Mô hình ngôn ngữ lớn có 5 giới hạn chính. Nó có thể bịa thông tin và mang thiên kiến từ dữ liệu. Nó không tự biết tin mới, có thể bỏ sót ý trong văn bản dài, và tốn nhiều chip, điện, tiền. IBM xếp ba điểm vào nhóm giới hạn của LLM: bịa thông tin, thiên kiến và nhu cầu lớn về tài nguyên.
- Bịa thông tin (hallucination): mô hình viết ra điều sai nhưng trông hợp lý, như một trích dẫn hay một tài liệu không có thật.
- Thiên kiến: định kiến có sẵn trong dữ liệu huấn luyện có thể đi vào câu trả lời.
- Kiến thức có hạn: mô hình dừng ở thời điểm dữ liệu cuối.
- Văn bản dài: thông tin nằm ở giữa có thể bị bỏ sót.
- Tốn tài nguyên: huấn luyện và vận hành cần nhiều chip, điện và tiền.
Theo nhóm tác giả InstructGPT, mô hình vẫn mắc lỗi đơn giản ngay cả sau bước học từ phản hồi của con người.
Hiện tượng mô hình ngôn ngữ lớn bịa thông tin là gì?
Theo IBM, mô hình bịa thông tin (hallucination) khi viết ra điều sai hoặc không có thật nhưng trông hợp lý. Nguyên nhân gốc nằm ở cách nó làm việc: mô hình chọn token có xác suất cao, không tra sự thật trước khi viết.
Bài báo InstructGPT cũng cho biết mô hình lớn hơn không tự động làm theo ý người dùng tốt hơn. Nó vẫn có thể viết ra điều sai sự thật, độc hại hoặc vô ích. Nguyên nhân chi tiết và cách giảm rủi ro nằm ở bài hiện tượng AI bịa thông tin.
Thiên kiến trong mô hình ngôn ngữ lớn là gì?
Thiên kiến trong mô hình ngôn ngữ lớn là việc mô hình lặp lại định kiến có sẵn trong dữ liệu huấn luyện. Khi đó câu trả lời thiên lệch về giới, vùng miền, văn hóa hay quan điểm. IBM xếp thiên kiến thừa hưởng từ dữ liệu huấn luyện vào nhóm giới hạn chính của LLM.
Mô hình học từ dữ liệu, nên góc nhìn chiếm nhiều chỗ trong dữ liệu cũng có thể chiếm nhiều chỗ trong câu trả lời. Các hãng chỉnh lại hành vi của mô hình qua bước căn chỉnh. Theo IBM, RLHF thường được dùng cho việc này. Anthropic thì xây bộ nguyên tắc cho Claude từ Tuyên ngôn Quốc tế Nhân quyền và từ nỗ lực đưa góc nhìn ngoài phương Tây vào. Căn chỉnh vẫn dựa trên lựa chọn của người chấm hoặc của bộ nguyên tắc, nên câu trả lời vẫn có thể mang thiên kiến.
Với người dùng Việt, cách kiểm tra thiết thực là so câu trả lời về lịch sử, văn hóa, luật lệ Việt Nam với nguồn chính thức trong nước. Khi câu trả lời có vẻ một chiều, bạn nên hỏi lại mô hình từ một góc khác.
Người dùng phổ thông cần hiểu gì để dùng mô hình ngôn ngữ lớn cho tốt?
Người dùng phổ thông cần nắm 5 điều để dùng mô hình ngôn ngữ lớn cho tốt, quan trọng nhất là mô hình đoán chữ chứ không tra sự thật.
- Mô hình đoán chữ chứ không tra sự thật: câu trả lời trôi chảy chưa chắc đã đúng. Sinh viên nhờ mô hình gợi ý tài liệu tham khảo nên mở từng tài liệu để chắc nó có thật.
- Câu hỏi rõ thì câu trả lời tốt hơn: nêu mục đích, người đọc, độ dài và đưa ví dụ mẫu khi cần. Cách làm chi tiết nằm ở bài cách viết prompt hiệu quả.
- Kiểm tra lại thông tin quan trọng: số liệu về tiền, sức khỏe, pháp luật phải so với nguồn chính thức. Cần cẩn thận nhất với tin mới hơn ngày dữ liệu cuối của mô hình, như tháng 4–5/2026 với các mô hình GPT-6.
- Không nhập dữ liệu nhạy cảm: số tài khoản, hồ sơ khách hàng hay tài liệu nội bộ của công ty không nên đưa vào chatbot dùng cho cá nhân. Mỗi hãng có chính sách riêng về việc dùng cuộc trò chuyện để huấn luyện.
- Tài liệu đưa vào có thể chứa câu lệnh ẩn: một trang web hay tệp PDF có thể giấu chỉ dẫn khiến mô hình làm điều bạn không yêu cầu. Đây là dạng tấn công bằng câu lệnh ẩn trong tài liệu.
Có hai thời điểm gần nhất đáng theo dõi. Vào hoặc trước ngày 15/11/2026, vụ dàn xếp Bartz dự kiến có đợt chi trả đầu tiên. Từ ngày 01/12/2026, giá Gemini 4 Argon tăng gấp đôi. Hai chủ đề nên đọc tiếp là vì sao AI bịa thông tin và các mô hình mở trọng số.
Cách đọc số liệu: Giá, cửa sổ ngữ cảnh, ngày giới hạn kiến thức và hạn mức lấy theo công bố của từng hãng, tra ngày 19/10/2026. Giá API là mức Standard, riêng giá OpenAI là mức ngữ cảnh ngắn, đầu vào tới 272.000 token. Trang giá của Google cập nhật ngày 16/10/2026. Số tiền đổi sang đồng theo tỷ giá bán của Vietcombank lúc 08:46 ngày 19/10/2026, 26.080 VND/USD.